原始课件 · 逐页中英对照

第1章 · 原课件与完整中文翻译

上方为英文原页,下方为对应的完整中文翻译,标题、正文、图内文字和公式按原页顺序排列。

← 回到第1章正文 · 全部课件

页号按PDF顺序。原课件的历史日期、学期、课堂安排和研究结论按原文保留;相关概念与适用条件见教程正文。符号、代码、作者姓名及便于检索的专有名称保留原文。

Lecture 01 · 89页

打开完整原PDF

p1p2p3p4p5p6p7p8p9p10p11p12p13p14p15p16p17p18p19p20p21p22p23p24p25p26p27p28p29p30p31p32p33p34p35p36p37p38p39p40p41p42p43p44p45p46p47p48p49p50p51p52p53p54p55p56p57p58p59p60p61p62p63p64p65p66p67p68p69p70p71p72p73p74p75p76p77p78p79p80p81p82p83p84p85p86p87p88p89

Lecture 01 · PDF p1

Lecture 1 英文原课件第1页
英文原页 · 点击在PDF中查看或放大
具身智能导论

第1讲:概览

王鹤教授

北京大学(1898年)

具身感知与交互实验室(EPIC)

2025年春季

Lecture 01 · PDF p2

Lecture 1 英文原课件第2页
英文原页 · 点击在PDF中查看或放大
关于我
  • 王鹤。
  • 计算机学院前沿计算研究中心(CFCS)助理教授。
  • Galbot 创始人及首席技术官。
  • 自2022年起领导北京智源人工智能研究院(BAAI)具身智能中心。
  • 2021年获得斯坦福大学博士学位。
  • 2014年获得清华大学学士学位。
  • 我们的实验室:具身感知与交互实验室(EPIC)。
  • 研究兴趣:具身智能。
  • 个人主页:https://hughw19.github.io/ 。

Lecture 01 · PDF p3

Lecture 1 英文原课件第3页
英文原页 · 点击在PDF中查看或放大
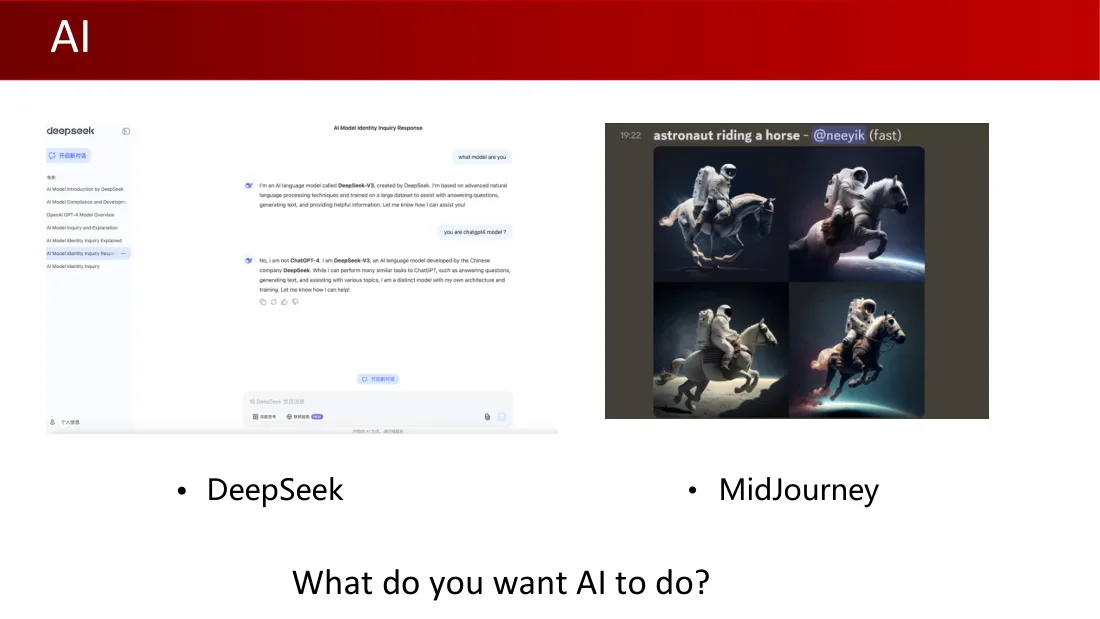
人工智能
  • DeepSeek。
  • MidJourney。

你希望人工智能做什么?

DeepSeek 对话标题:人工智能模型身份询问的回答。

用户:你是什么模型?

回答:我是一个名为 DeepSeek-V3 的人工智能语言模型,由 DeepSeek 创建。我基于先进的自然语言处理技术,并在大型数据集上接受训练,以帮助回答问题、生成文本和提供有用信息。告诉我可以怎样帮助你!

用户:你是 ChatGPT-4 模型吗?

回答:不,我不是 ChatGPT-4。我是 DeepSeek-V3,是中国公司 DeepSeek 开发的人工智能语言模型。虽然我能完成许多与 ChatGPT 类似的任务,例如回答问题、生成文本和协助处理各种话题,但我是一个独立的模型,有自己的架构和训练过程。告诉我可以怎样帮助你!

DeepSeek 侧栏:DeepSeek 的人工智能模型介绍;人工智能模型合规与开发…;OpenAI GPT-4 模型概览;人工智能模型询问与解释;人工智能模型身份询问的说明;人工智能模型身份询问的回答…;人工智能模型身份询问。新增。

Midjourney 提示词:骑马的宇航员——@neeyik(快速模式),19:22。

Discord 界面:公开;首页;1个活动;频道与身份组;新增;信息;公告;最近的更改;状态;规则;入门指南;支持;试用支持;新用户房间;新用户房间2;新手41、新手11、新手71;向新手11频道发送消息。

新手11频道:供新用户使用的机器人房间。输入 /imagine,然后描述你想画什么。参见 https://docs… 。

自19:21以来有37条新消息;标记为已读。

图像操作按钮:U1、U2、U3、U4;V1、V2、V3、V4。

Lecture 01 · PDF p4

Lecture 1 英文原课件第4页
英文原页 · 点击在PDF中查看或放大
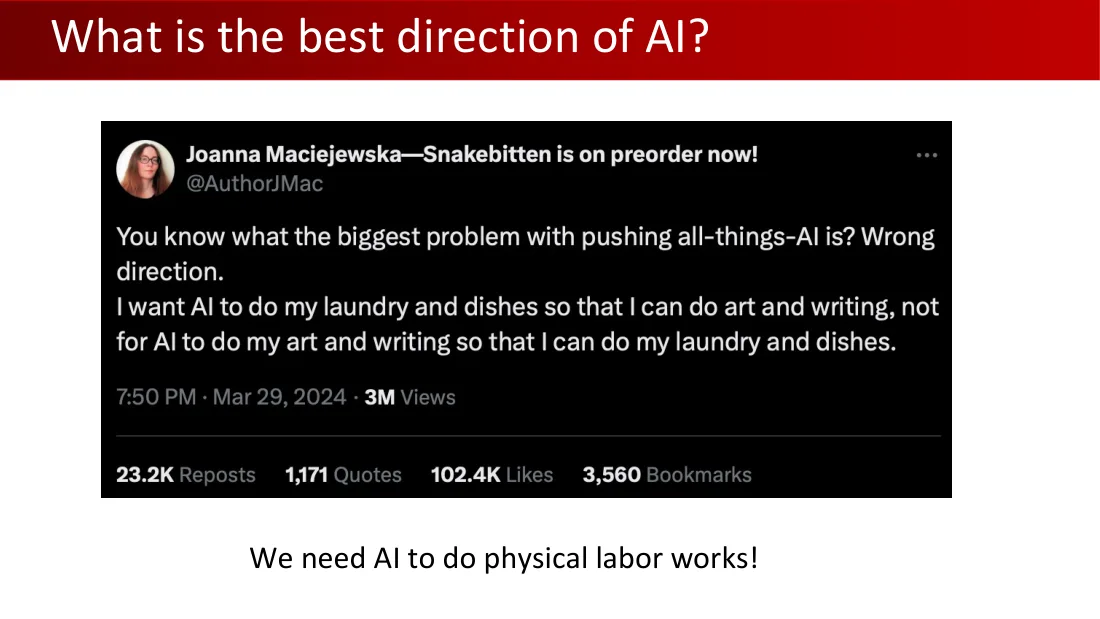
人工智能的最佳方向是什么?

Joanna Maciejewska——《Snakebitten》现已开放预订!@AuthorJMac。

你知道推动“万事皆人工智能”的最大问题是什么吗?方向错了。

我希望人工智能替我洗衣服、洗碗,好让我进行艺术创作和写作,而不是让人工智能替我进行艺术创作和写作,好让我洗衣服、洗碗。

2024年3月29日19:50;300万次浏览;2.32万次转发;1,171次引用;10.24万个赞;3,560次收藏。

我们需要人工智能来从事体力劳动!

Lecture 01 · PDF p5

Lecture 1 英文原课件第5页
英文原页 · 点击在PDF中查看或放大
从机器人学到具身智能

Lecture 01 · PDF p6

Lecture 1 英文原课件第6页
英文原页 · 点击在PDF中查看或放大
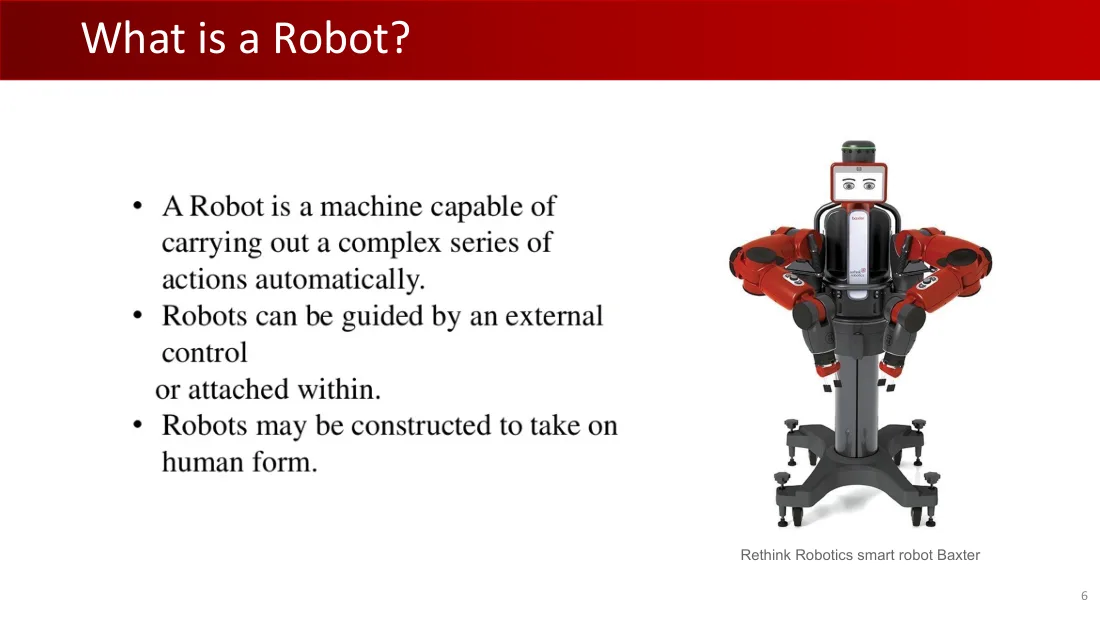
什么是机器人?
  • 机器人是一种能够自动执行一系列复杂动作的机器。
  • 机器人可以由外部控制装置引导,也可以由安装在内部的控制装置引导。
  • 机器人可以被制造成人的形态。

Rethink Robotics 的智能机器人 Baxter。

Lecture 01 · PDF p7

Lecture 1 英文原课件第7页
英文原页 · 点击在PDF中查看或放大
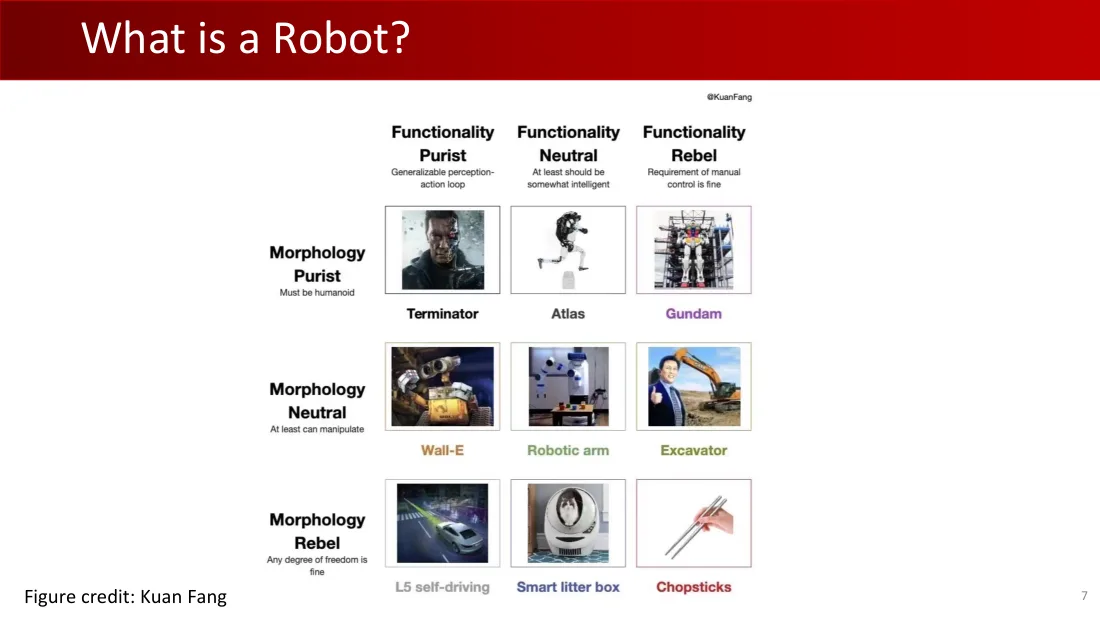
什么是机器人?
形态 / 功能功能纯粹派:可泛化的感知—行动闭环功能中立派:至少应当有一定智能功能叛逆派:需要人工控制也可以
形态纯粹派:必须是人形终结者Atlas高达
形态中立派:至少能够进行操作瓦力(Wall-E)机械臂挖掘机
形态叛逆派:具有任何自由度都可以L5级自动驾驶智能猫砂盆筷子

图片来源:Kuan Fang;@KuanFang。

Lecture 01 · PDF p8

Lecture 1 英文原课件第8页
英文原页 · 点击在PDF中查看或放大
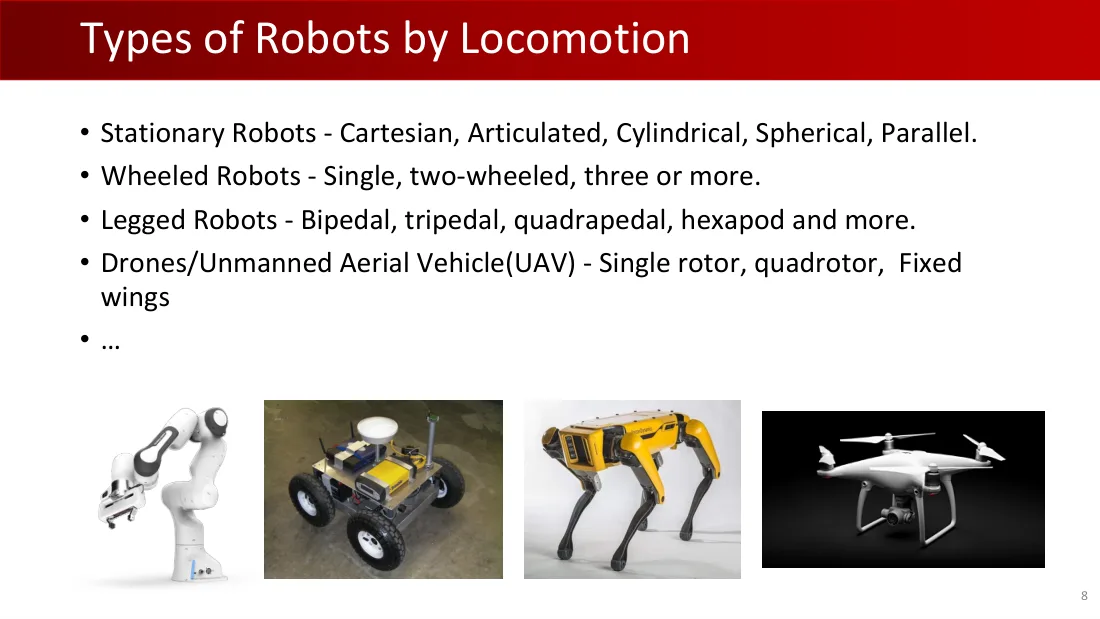
按移动方式划分的机器人类型
  • 固定式机器人:笛卡尔式、关节式、圆柱式、球面式、并联式。
  • 轮式机器人:单轮、双轮、三轮或更多轮。
  • 足式机器人:双足、三足、四足、六足或更多足。
  • 无人机/无人驾驶飞行器(UAV):单旋翼、四旋翼、固定翼。
  • ……

Lecture 01 · PDF p9

Lecture 1 英文原课件第9页
英文原页 · 点击在PDF中查看或放大
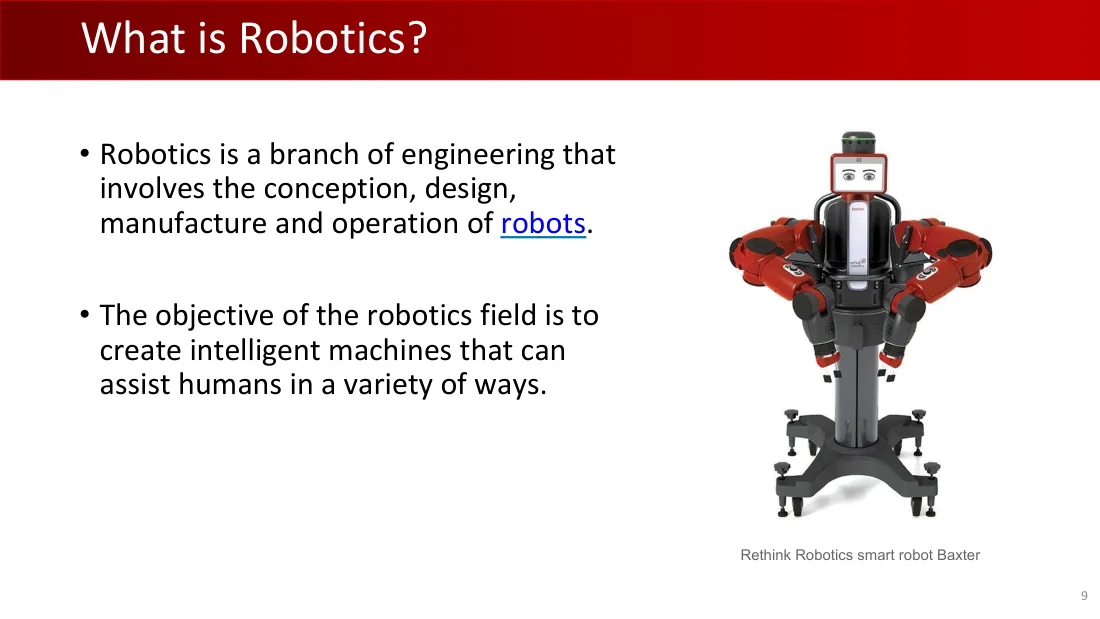
什么是机器人学?
  • 机器人学是工程学的一个分支,涉及机器人的构思、设计、制造和运行。
  • 机器人学领域的目标是创造能以多种方式帮助人类的智能机器。

Rethink Robotics 的智能机器人 Baxter。

Lecture 01 · PDF p10

Lecture 1 英文原课件第10页
英文原页 · 点击在PDF中查看或放大
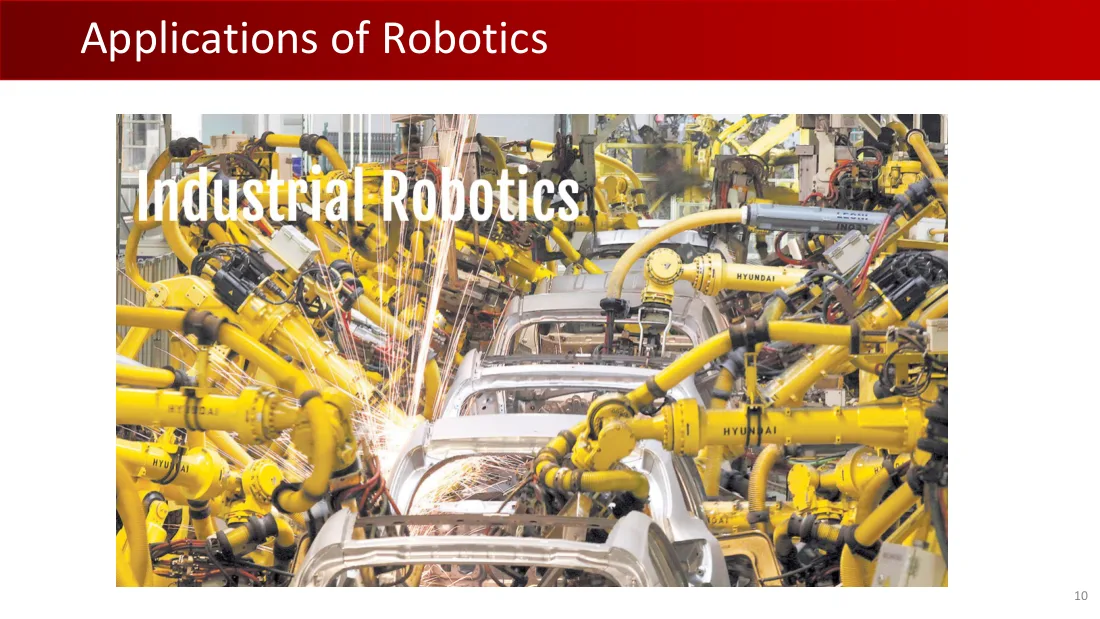
机器人学的应用

工业机器人。

Lecture 01 · PDF p11

Lecture 1 英文原课件第11页
英文原页 · 点击在PDF中查看或放大
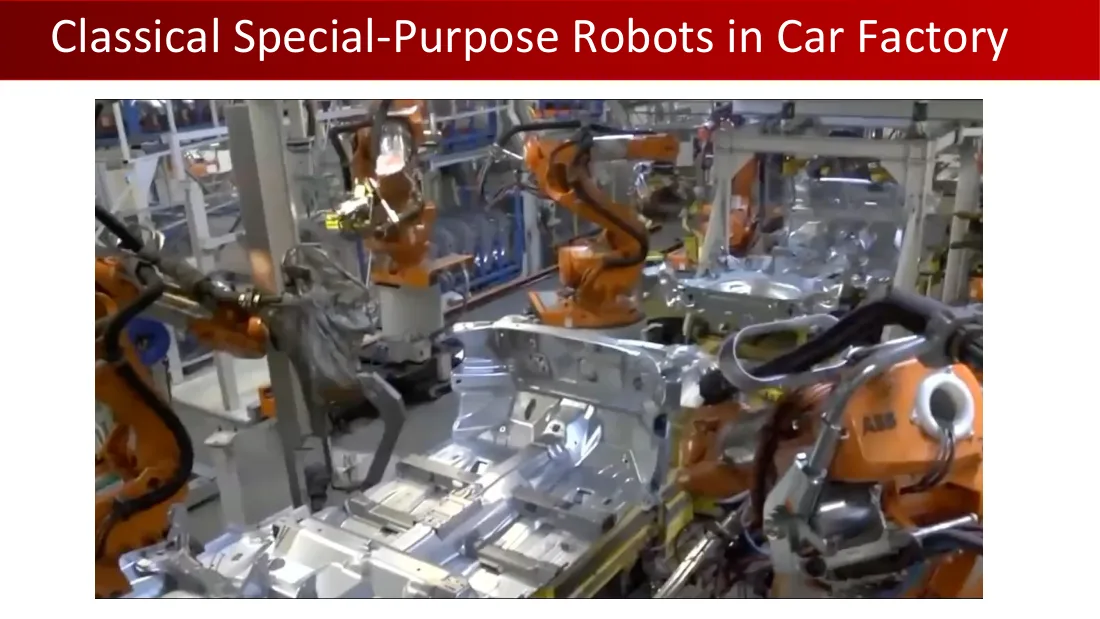
汽车工厂中的传统专用机器人

Lecture 01 · PDF p12

Lecture 1 英文原课件第12页
英文原页 · 点击在PDF中查看或放大
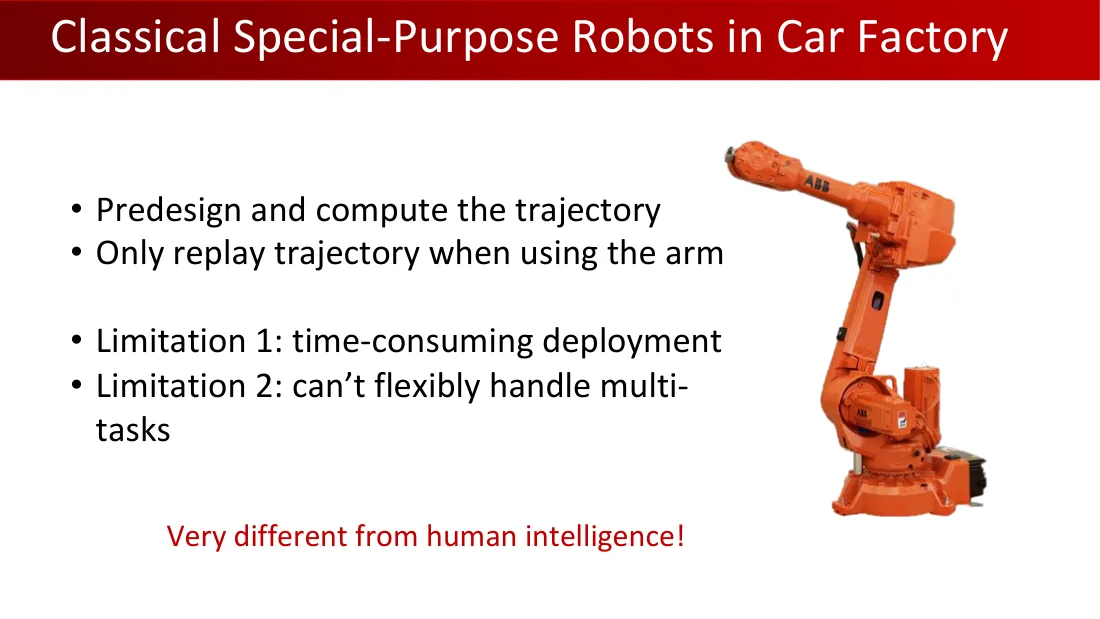
汽车工厂中的传统专用机器人
  • 预先设计并计算轨迹。
  • 使用机械臂时只回放轨迹。
  • 局限1:部署耗时。
  • 局限2:无法灵活处理多种任务。

与人类智能非常不同!

Lecture 01 · PDF p13

Lecture 1 英文原课件第13页
英文原页 · 点击在PDF中查看或放大
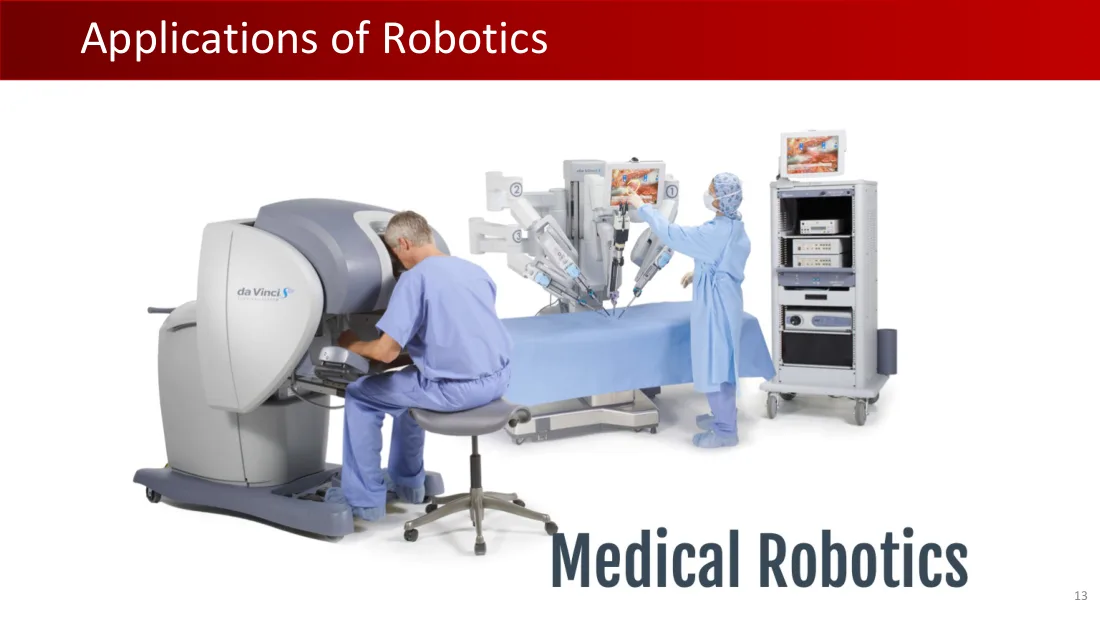
机器人学的应用

医疗机器人。

Lecture 01 · PDF p14

Lecture 1 英文原课件第14页
英文原页 · 点击在PDF中查看或放大
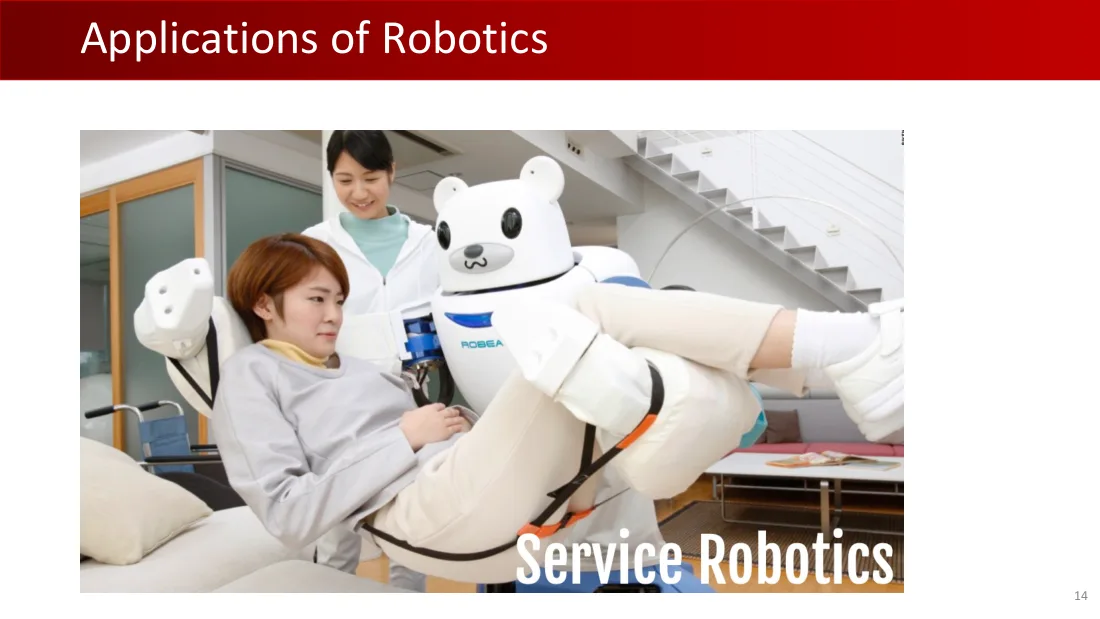
机器人学的应用

服务机器人。

Lecture 01 · PDF p15

Lecture 1 英文原课件第15页
英文原页 · 点击在PDF中查看或放大
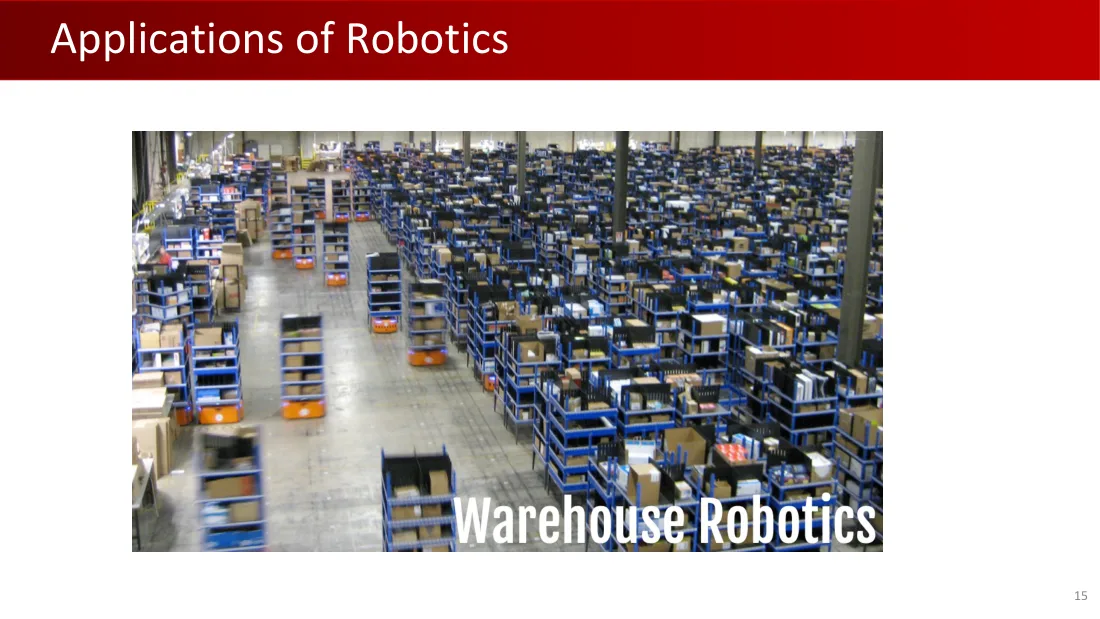
机器人学的应用

仓储机器人。

Lecture 01 · PDF p16

Lecture 1 英文原课件第16页
英文原页 · 点击在PDF中查看或放大
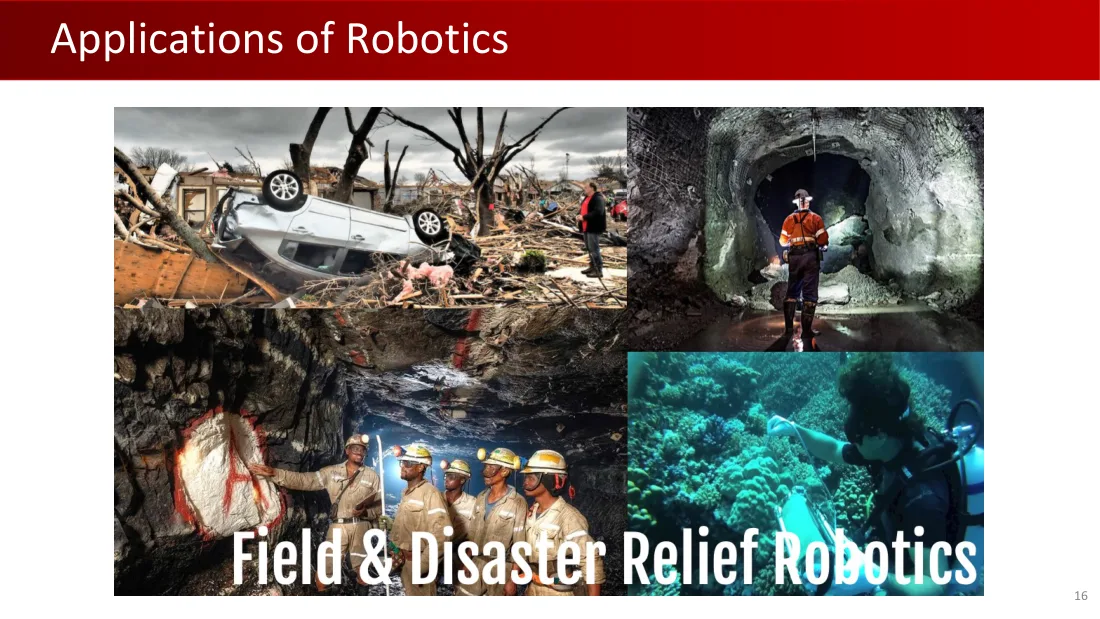
机器人学的应用

野外与救灾机器人。

Lecture 01 · PDF p17

Lecture 1 英文原课件第17页
英文原页 · 点击在PDF中查看或放大
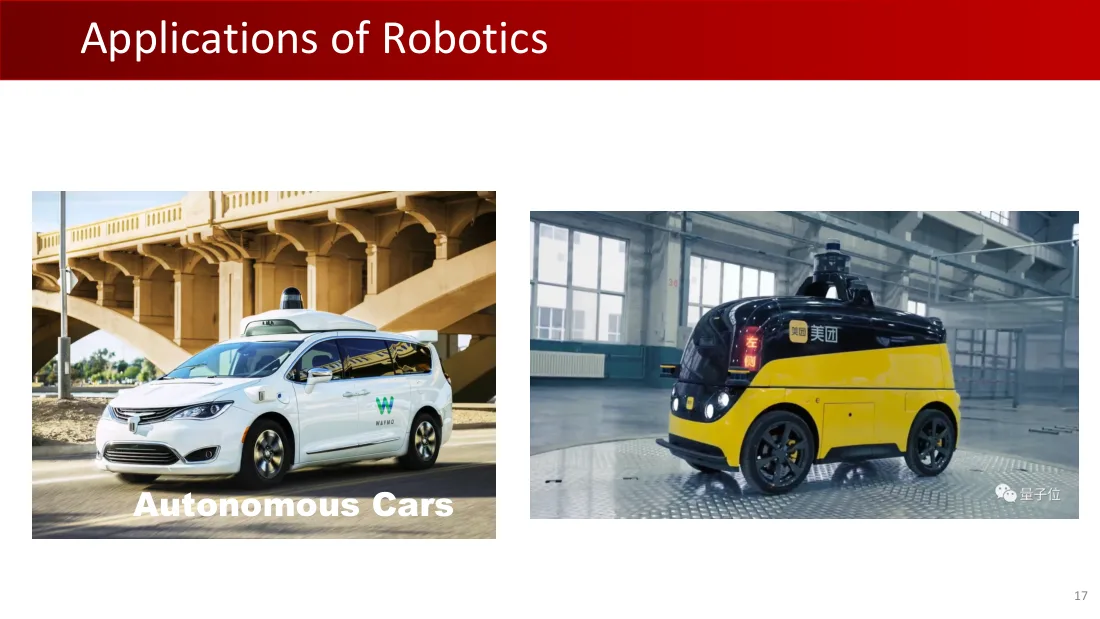
机器人学的应用

自动驾驶汽车。

Lecture 01 · PDF p18

Lecture 1 英文原课件第18页
英文原页 · 点击在PDF中查看或放大
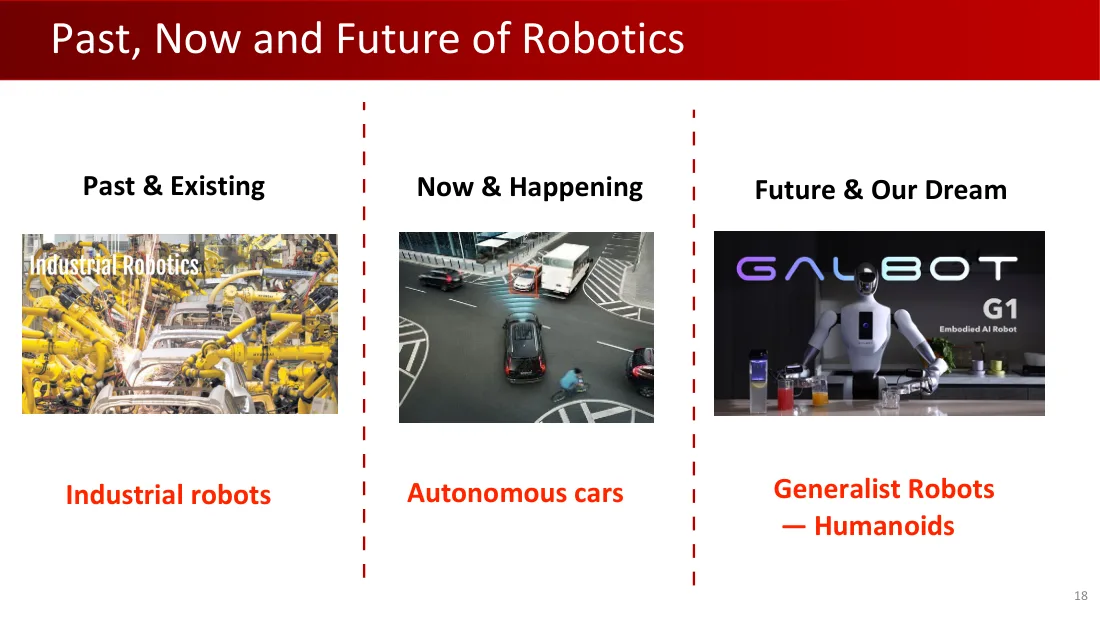
机器人学的过去、现在与未来
过去与已有现在与正在发生未来与我们的梦想
工业机器人自动驾驶汽车通用机器人——人形机器人

Galbot G1:具身智能机器人。

Lecture 01 · PDF p19

Lecture 1 英文原课件第19页
英文原页 · 点击在PDF中查看或放大
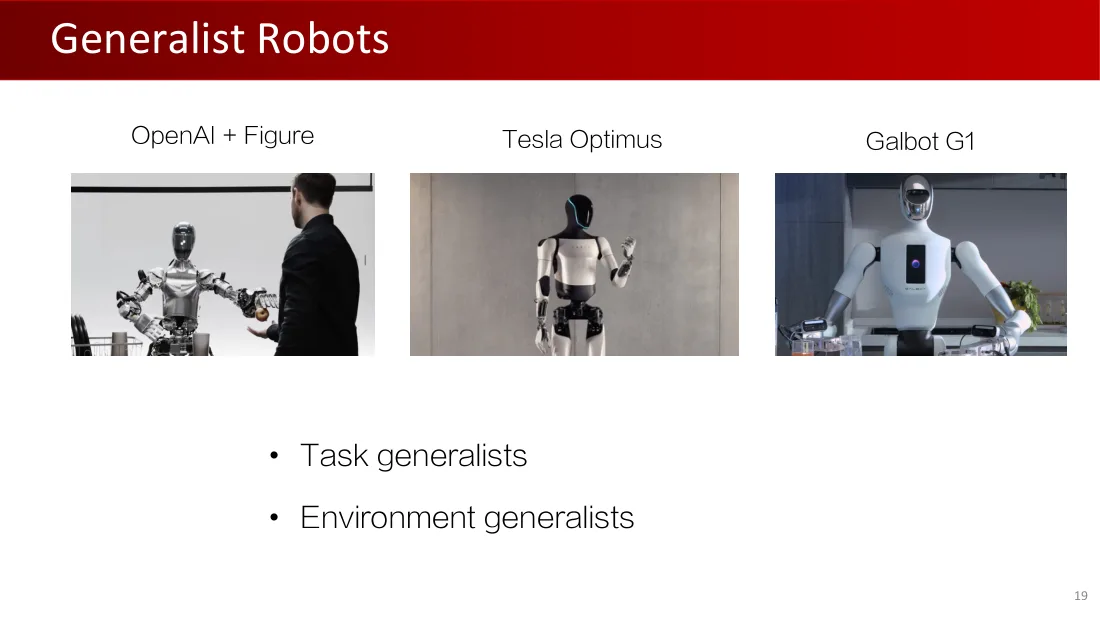
通用机器人

OpenAI + Figure

Tesla Optimus(特斯拉擎天柱)

Galbot G1

  • 任务通用。
  • 环境通用。

Lecture 01 · PDF p20

Lecture 1 英文原课件第20页
英文原页 · 点击在PDF中查看或放大
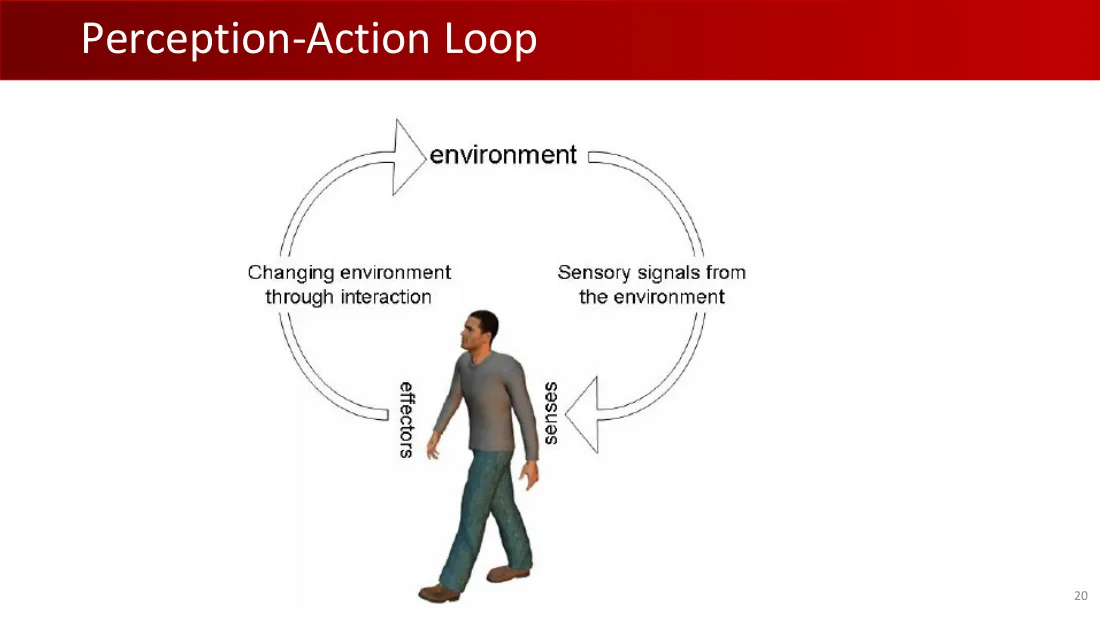
感知—行动闭环

环境。

通过交互改变环境。

来自环境的感觉信号。

效应器。

感官。

Lecture 01 · PDF p21

Lecture 1 英文原课件第21页
英文原页 · 点击在PDF中查看或放大
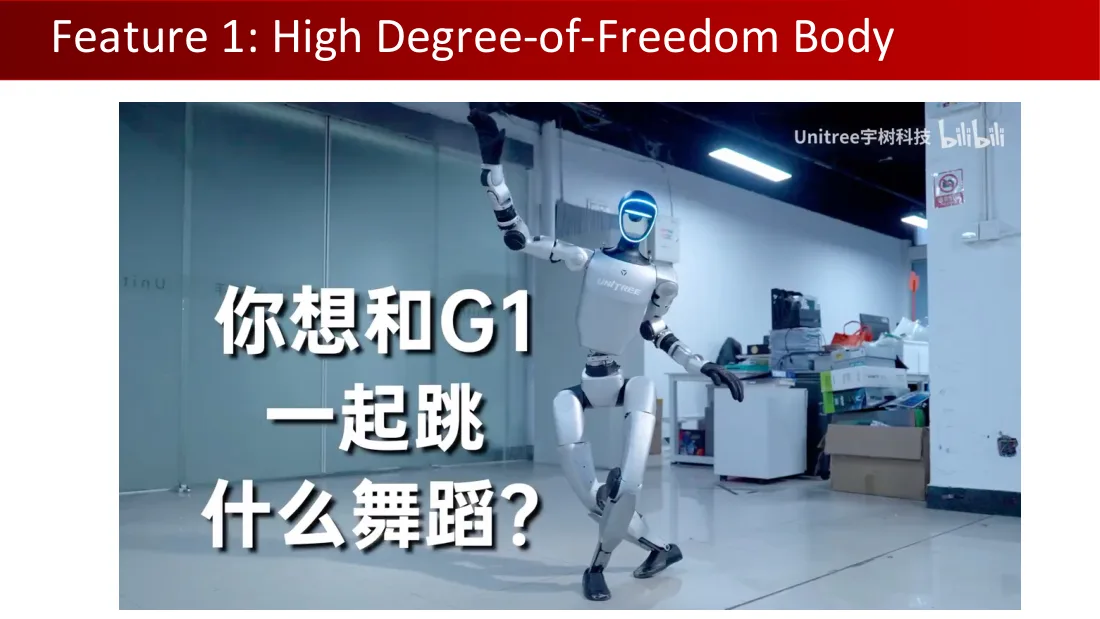
特征1:高自由度的身体

你想和 G1 一起跳什么舞蹈?

Unitree 宇树;哔哩哔哩。

Lecture 01 · PDF p22

Lecture 1 英文原课件第22页
英文原页 · 点击在PDF中查看或放大
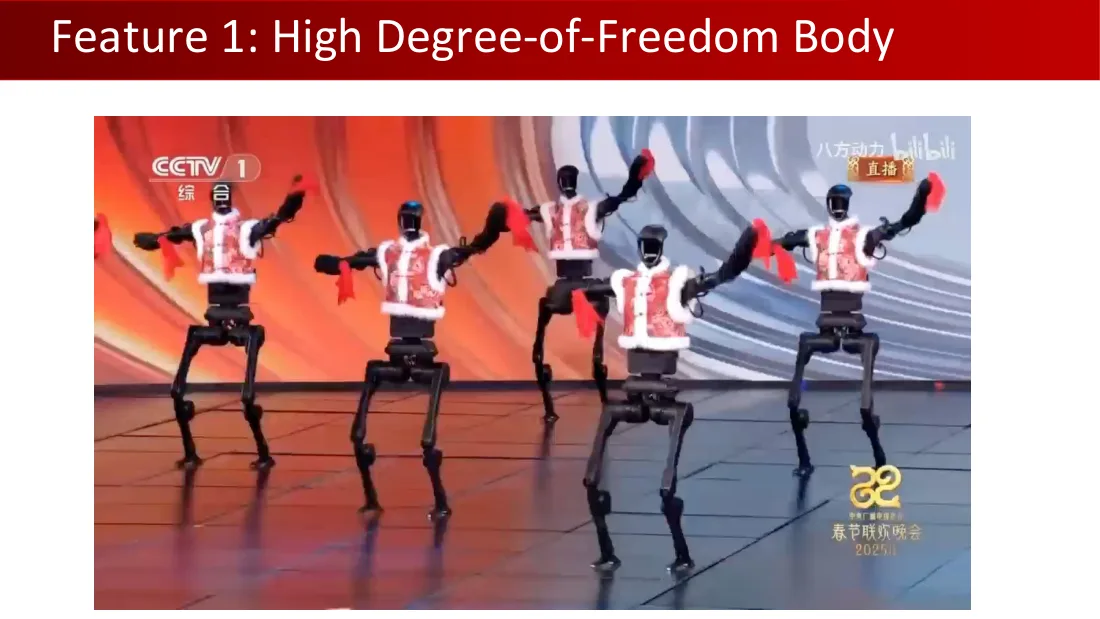
特征1:高自由度的身体

CCTV 1 综合;2025春节联欢晚会。

Lecture 01 · PDF p23

Lecture 1 英文原课件第23页
英文原页 · 点击在PDF中查看或放大
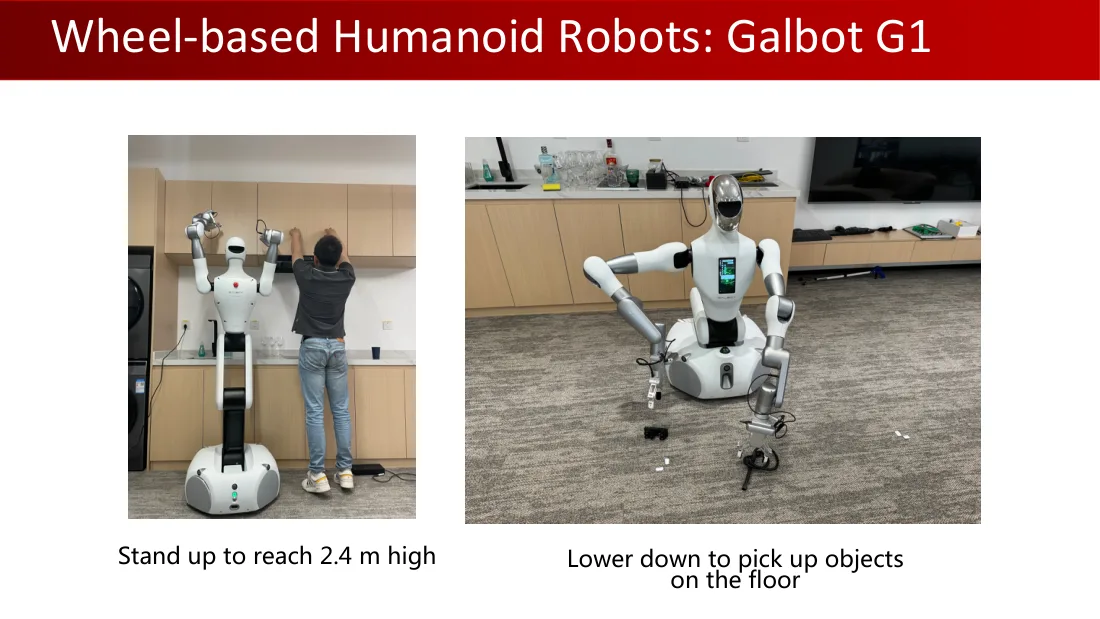
轮式人形机器人:Galbot G1

伸展身体,可触及2.4米高处。

降低身体,拾取地面物体。

Lecture 01 · PDF p24

Lecture 1 英文原课件第24页
英文原页 · 点击在PDF中查看或放大
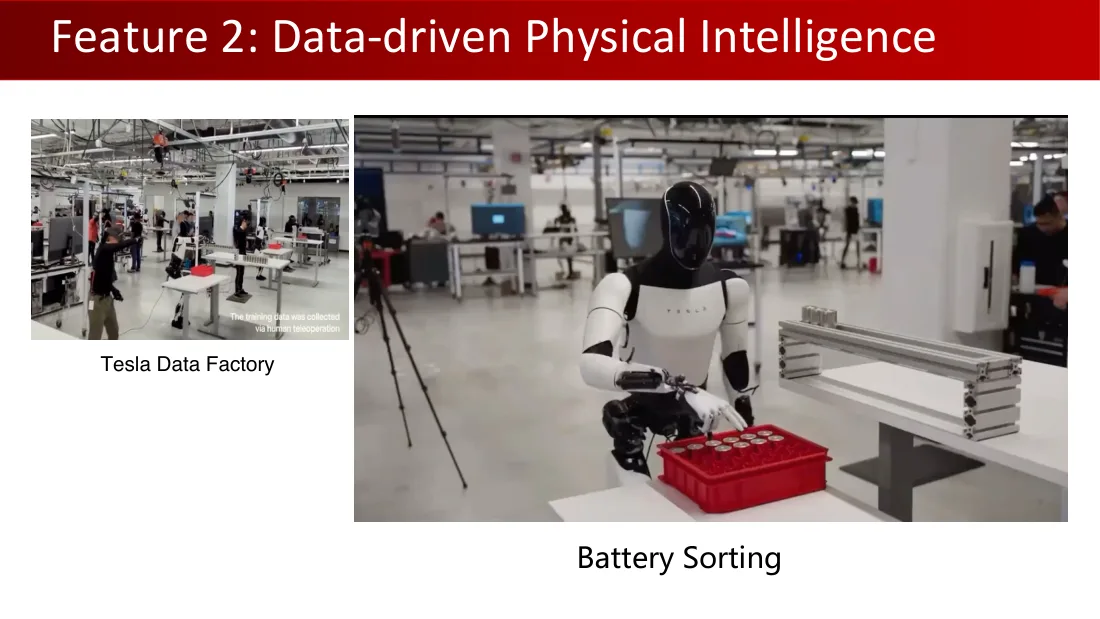
特征2:数据驱动的物理智能

特斯拉数据工厂。

训练数据通过人类遥操作收集。

采集抓取数据。

电池分拣。

Lecture 01 · PDF p25

Lecture 1 英文原课件第25页
英文原页 · 点击在PDF中查看或放大
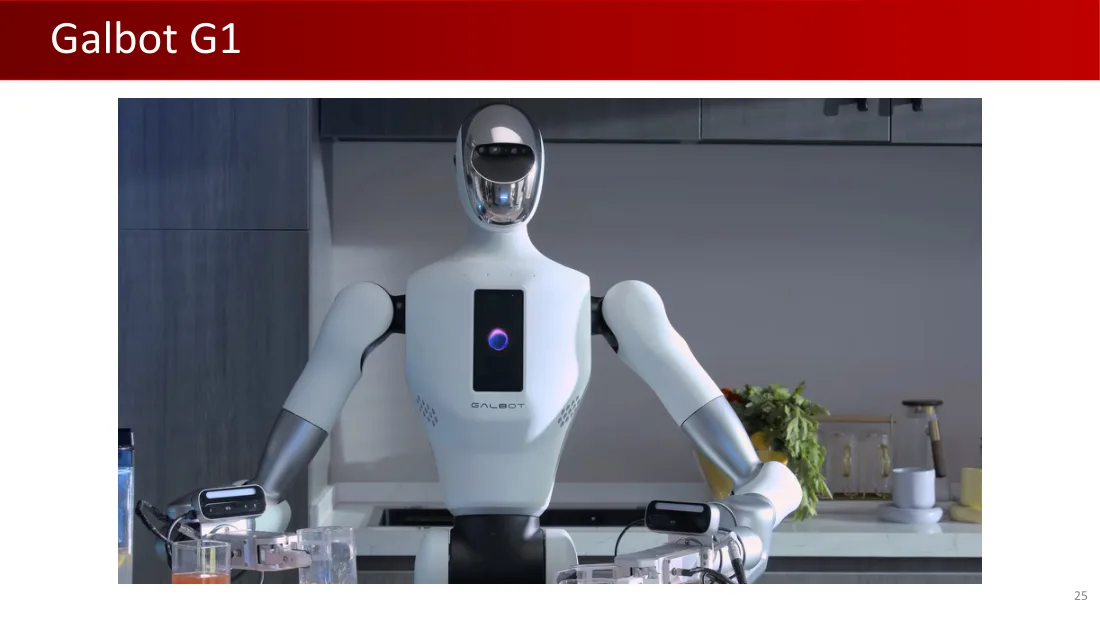
Galbot G1

Galbot。

Lecture 01 · PDF p26

Lecture 1 英文原课件第26页
英文原页 · 点击在PDF中查看或放大
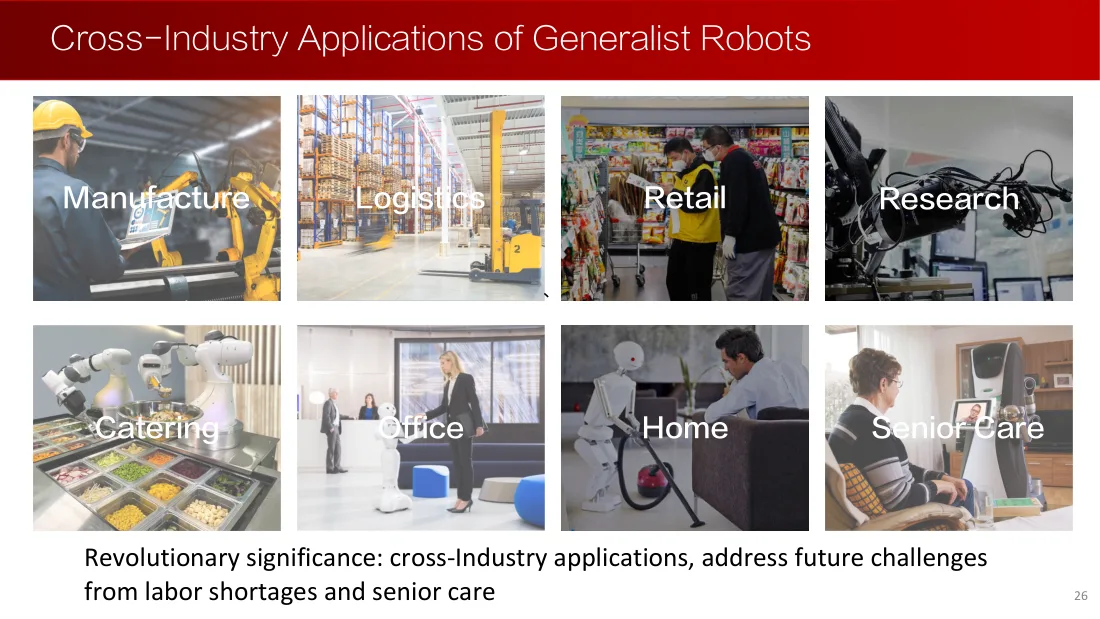
通用机器人的跨行业应用
制造物流零售科研
餐饮办公家庭养老

革命性意义:跨行业应用,应对未来劳动力短缺与养老带来的挑战。

Lecture 01 · PDF p27

Lecture 1 英文原课件第27页
英文原页 · 点击在PDF中查看或放大
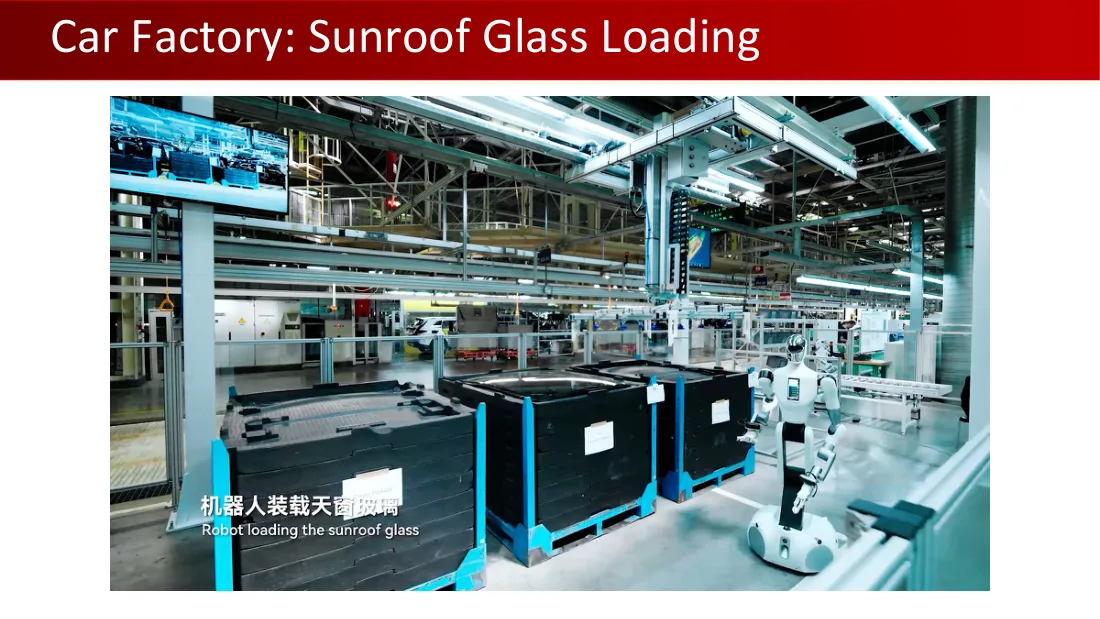
汽车工厂:天窗玻璃上料

机器人为天窗玻璃上料。

Lecture 01 · PDF p28

Lecture 1 英文原课件第28页
英文原页 · 点击在PDF中查看或放大
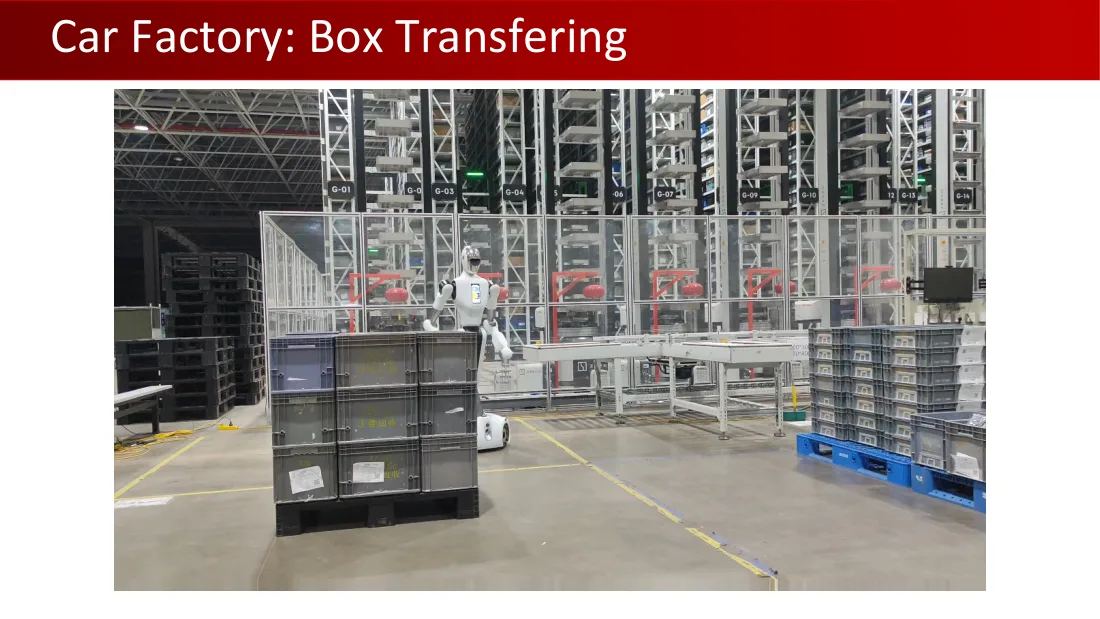
汽车工厂:箱体搬运

Lecture 01 · PDF p29

Lecture 1 英文原课件第29页
英文原页 · 点击在PDF中查看或放大
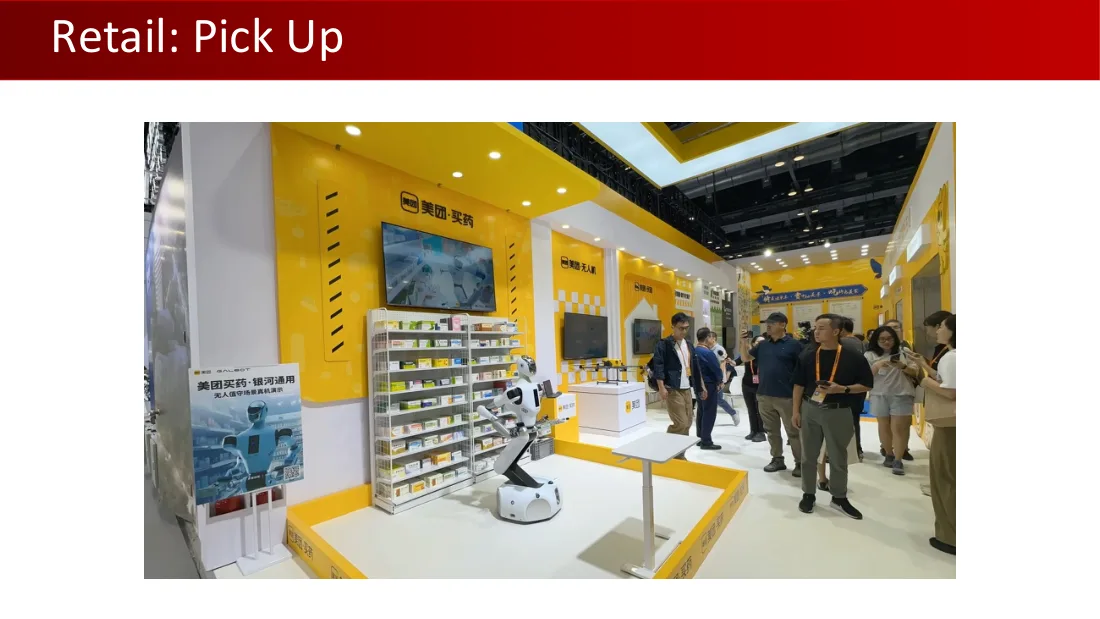
零售:取货

Lecture 01 · PDF p30

Lecture 1 英文原课件第30页
英文原页 · 点击在PDF中查看或放大
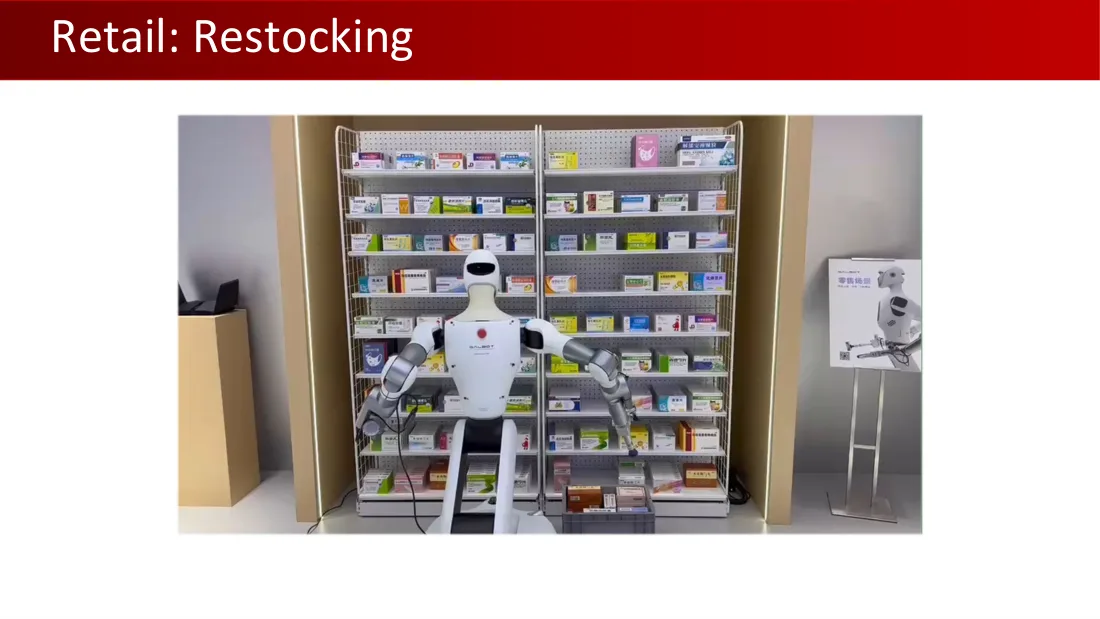
零售:补货

Lecture 01 · PDF p31

Lecture 1 英文原课件第31页
英文原页 · 点击在PDF中查看或放大
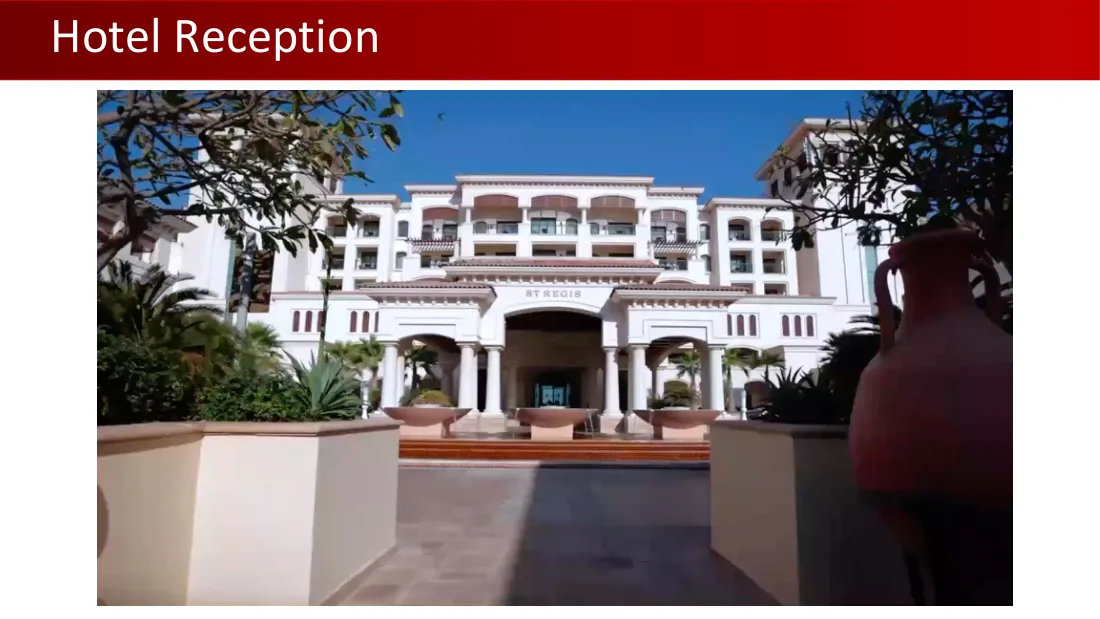
酒店接待

瑞吉酒店(St. Regis)。

Lecture 01 · PDF p32

Lecture 1 英文原课件第32页
英文原页 · 点击在PDF中查看或放大
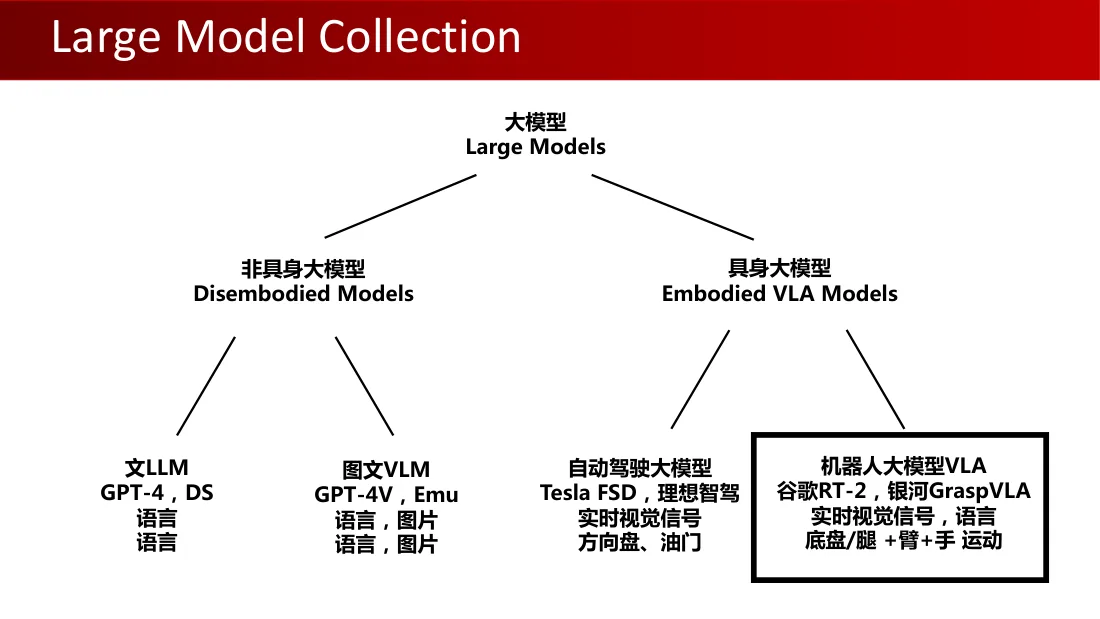
大模型集合

大模型

非具身大模型具身大模型
语言大模型(LLM)图文视觉语言模型(VLM)自动驾驶大模型机器人视觉—语言—动作大模型(VLA)
GPT-4、DSGPT-4V、EmuTesla FSD、理想智驾谷歌 RT-2、银河 GraspVLA
语言语言、图片实时视觉信号实时视觉信号、语言
语言语言、图片方向盘、油门底盘/腿、臂、手运动

Lecture 01 · PDF p33

Lecture 1 英文原课件第33页
英文原页 · 点击在PDF中查看或放大
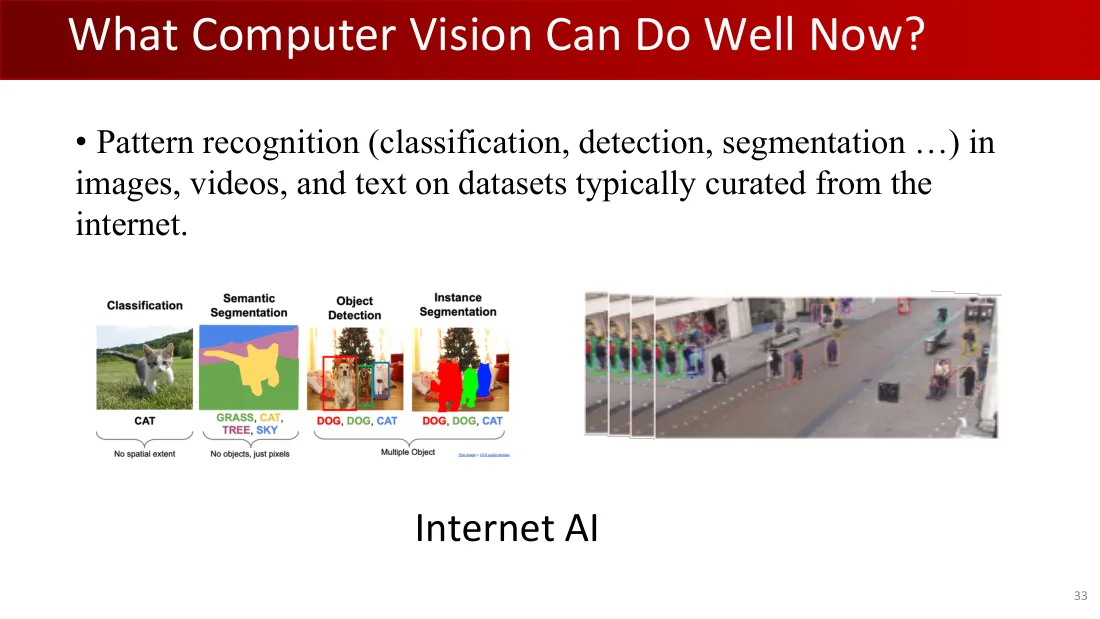
现在计算机视觉擅长做什么?
  • 对图像、视频和文本进行模式识别(分类、检测、分割……),使用的数据集通常经过整理,来源于互联网。

分类:猫;没有空间范围。

语义分割:草、猫、树、天空;没有对象,只有像素。

目标检测:狗、狗、猫;多个对象。

实例分割:狗、狗、猫。

互联网人工智能。

Lecture 01 · PDF p34

Lecture 1 英文原课件第34页
英文原页 · 点击在PDF中查看或放大
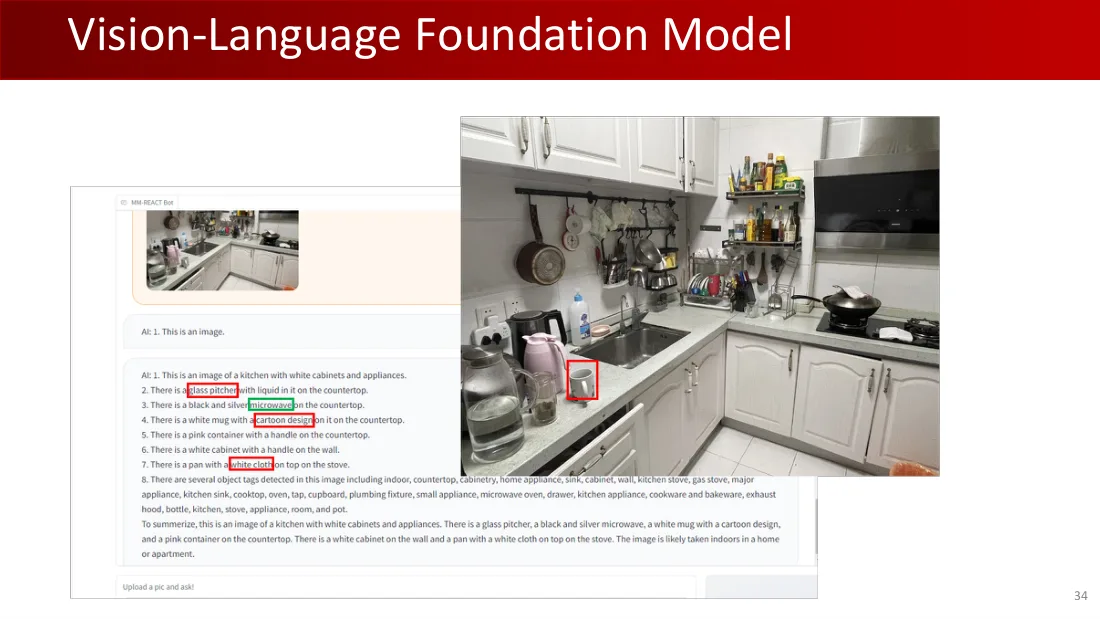
视觉语言基础模型

MM-REACT 机器人。

人工智能:1. 这是一张图片。

人工智能:1. 这是一张带有白色橱柜和电器的厨房图片。

2. 台面上有一个装着液体的玻璃水壶。

3. 台面上有一台黑银色微波炉。

4. 台面上有一个带卡通图案的白色杯子。

5. 台面上有一个带把手的粉色容器。

6. 墙上有一个带把手的白色橱柜。

7. 炉灶上有一口锅,锅上放着白布。

8. 这张图片中检测到多个对象标签,包括室内、台面、橱柜、家用电器、水槽、柜体、墙壁、厨房炉灶、燃气灶、大型电器、厨房水槽、灶台、烤箱、水龙头、碗柜、管道装置、小型电器、微波炉、抽屉、厨房电器、炊具与烘焙器具、抽油烟机、瓶子、厨房、炉子、电器、房间和锅。

概括而言,这是一张带有白色橱柜和电器的厨房图片。台面上有一个玻璃水壶、一台黑银色微波炉、一个带卡通图案的白色杯子和一个粉色容器。墙上有一个白色橱柜,炉灶上有一口锅,锅上放着白布。这张图片很可能拍摄于住宅或公寓室内。

上传图片并提问!

Lecture 01 · PDF p35

Lecture 1 英文原课件第35页
英文原页 · 点击在PDF中查看或放大
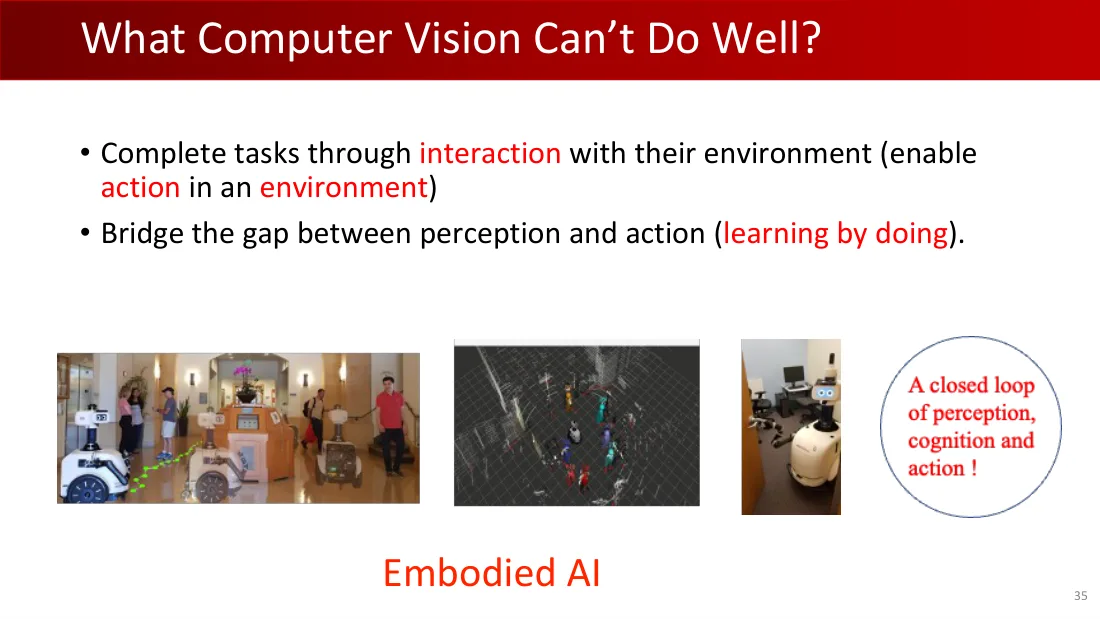
计算机视觉不擅长做什么?
  • 通过与环境交互来完成任务(使其能在环境中行动)。
  • 弥合感知与行动之间的鸿沟(在做中学)。

感知、认知和行动的闭环!

具身智能。

Lecture 01 · PDF p36

Lecture 1 英文原课件第36页
英文原页 · 点击在PDF中查看或放大
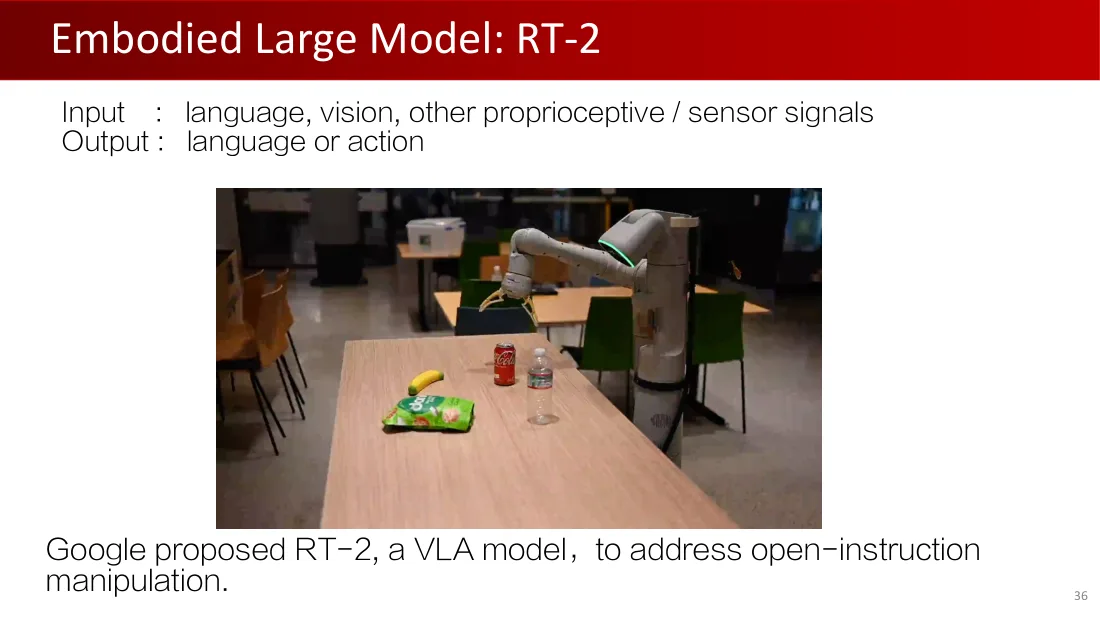
具身大模型:RT-2

输入:语言、视觉、其他本体感觉/传感器信号。

输出:语言或动作。

谷歌提出了 RT-2,一种视觉—语言—动作(VLA)模型,用于解决开放指令操作问题。

Lecture 01 · PDF p37

Lecture 1 英文原课件第37页
英文原页 · 点击在PDF中查看或放大
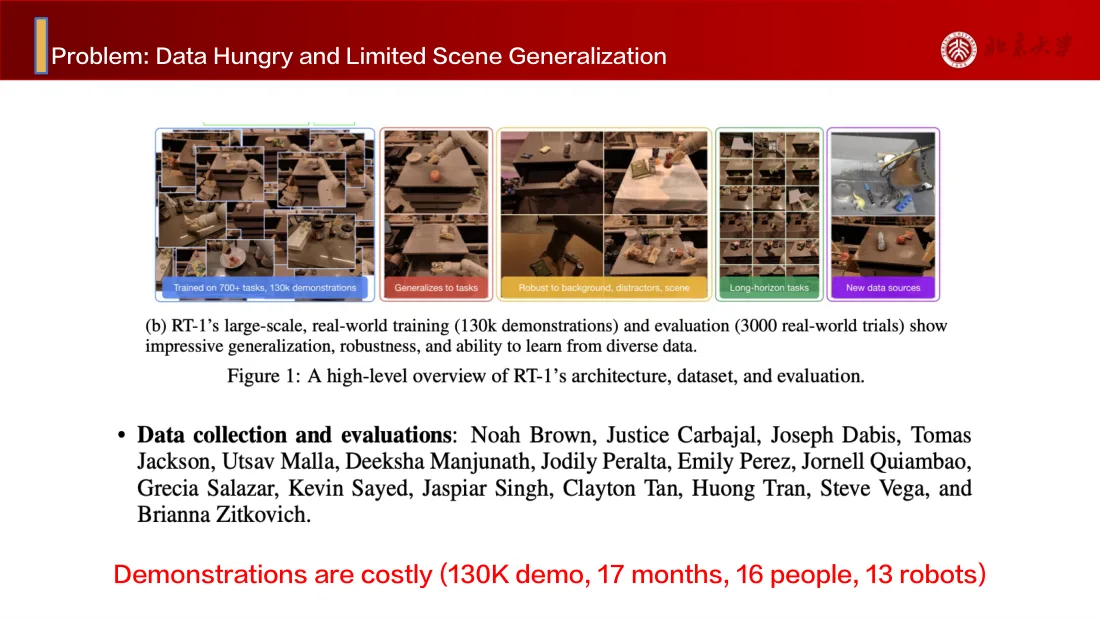
问题:数据需求大,场景泛化有限

在700多种任务、13万条示范上训练。

泛化到任务。

对背景、干扰物与场景具有鲁棒性。

长时域任务。

新的数据来源。

(b) RT-1 的大规模真实世界训练(13万条示范)与评估(3,000次真实世界试验)展示了出色的泛化能力、鲁棒性,以及从多样化数据中学习的能力。

图1:RT-1 的架构、数据集与评估的总体概览。

  • 数据采集与评估:Noah Brown、Justice Carbajal、Joseph Dabis、Tomas Jackson、Utsav Malla、Deeksha Manjunath、Jodily Peralta、Emily Perez、Jornell Quiambao、Grecia Salazar、Kevin Sayed、Jaspiar Singh、Clayton Tan、Huong Tran、Steve Vega、Brianna Zitkovich。

示范数据的成本高昂(13万条示范,17个月,16人,13台机器人)。

Lecture 01 · PDF p38

Lecture 1 英文原课件第38页
英文原页 · 点击在PDF中查看或放大
真实数据采集

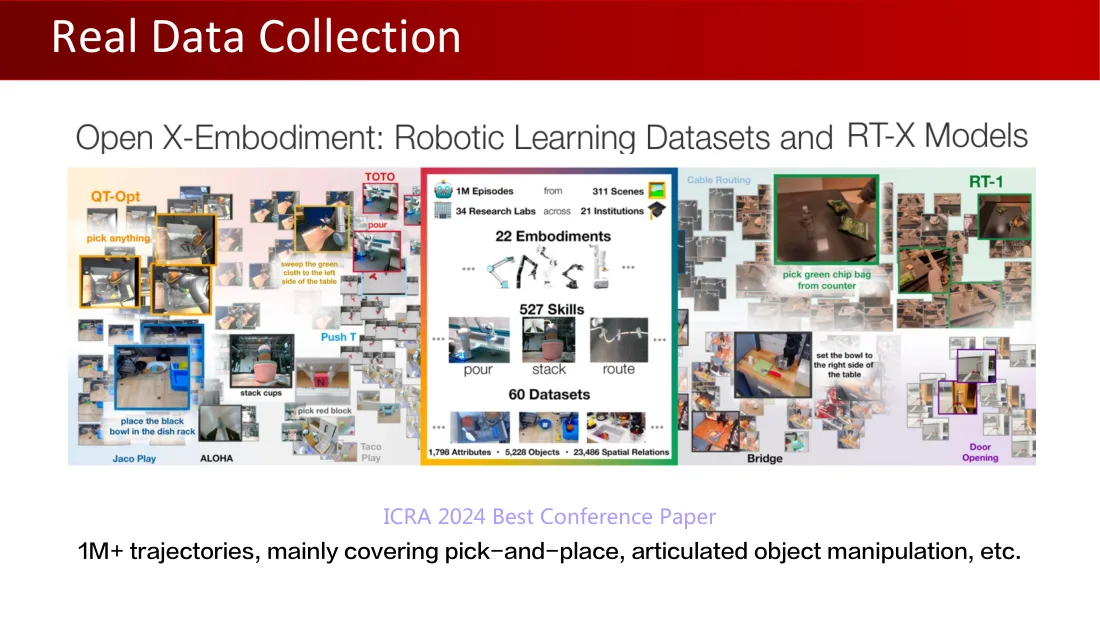
Open X-Embodiment:机器人学习数据集与 RT-X 模型。

Open X-Embodiment 合作团队(悬停可显示完整作者名单)。

来自311个场景的100万条交互回合;跨21所机构的34个研究实验室;22种具身形态;527种技能;60个数据集;1,798种属性;5,228种对象;23,486种空间关系。

技能:倾倒、堆叠、布线。

QT-Opt:拾取任何物体;把绿色布扫到桌子左侧。

TOTO:倾倒。

Jaco Play:把黑碗放进沥水架。

ALOHA:堆叠杯子。

Push T;Taco Play:拾取红色积木。

电缆布线。

RT-1:从台面拾取绿色薯片袋。

Bridge:把碗放到桌子右侧。

开门。

ICRA 2024 最佳会议论文。

100多万条轨迹,主要涵盖抓取放置、关节物体操作等。

Lecture 01 · PDF p39

Lecture 1 英文原课件第39页
英文原页 · 点击在PDF中查看或放大
数据瓶颈

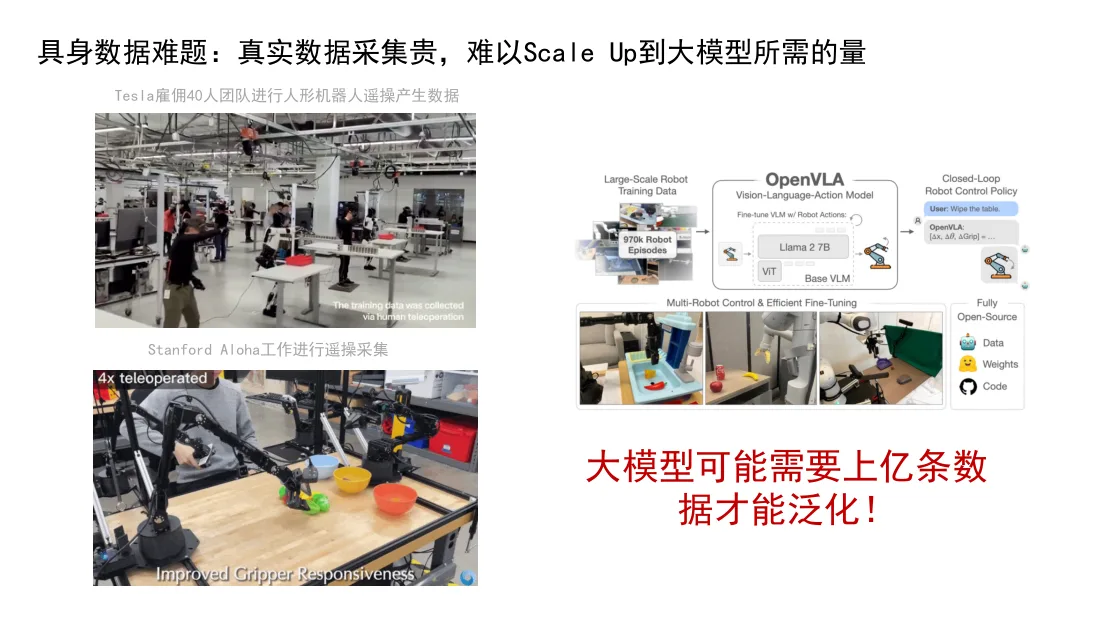
具身数据难题:真实数据采集贵,难以规模化到大模型所需的量。

Tesla 雇佣40人团队进行人形机器人遥操作,以产生数据。

训练数据通过人类遥操作收集。

Stanford ALOHA 工作通过遥操作采集数据。

4倍速遥操作;改进的夹爪响应。

大模型可能需要上亿条数据才能泛化!

OpenVLA:视觉—语言—动作模型。

大规模机器人训练数据:97万条机器人交互回合。

使用机器人动作微调视觉语言模型;基础视觉语言模型;Llama 2 7B;视觉 Transformer(ViT)。

闭环机器人控制策略:用户“擦桌子”;OpenVLA 输出 \([\Delta x,\Delta\theta,\Delta\mathrm{Grip}]\) = … 。

多机器人控制与高效微调。

完全开源:数据、权重、代码。

Lecture 01 · PDF p40

Lecture 1 英文原课件第40页
英文原页 · 点击在PDF中查看或放大
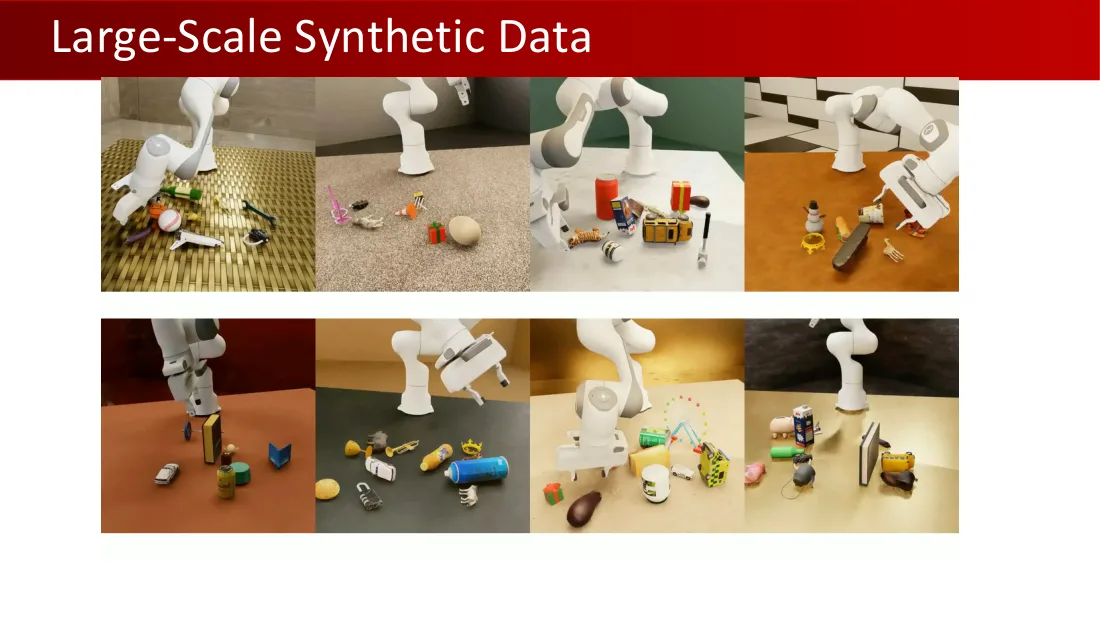
大规模合成数据

Lecture 01 · PDF p41

Lecture 1 英文原课件第41页
英文原页 · 点击在PDF中查看或放大
GraspVLA

Galbot;北京大学。

Lecture 01 · PDF p42

Lecture 1 英文原课件第42页
英文原页 · 点击在PDF中查看或放大
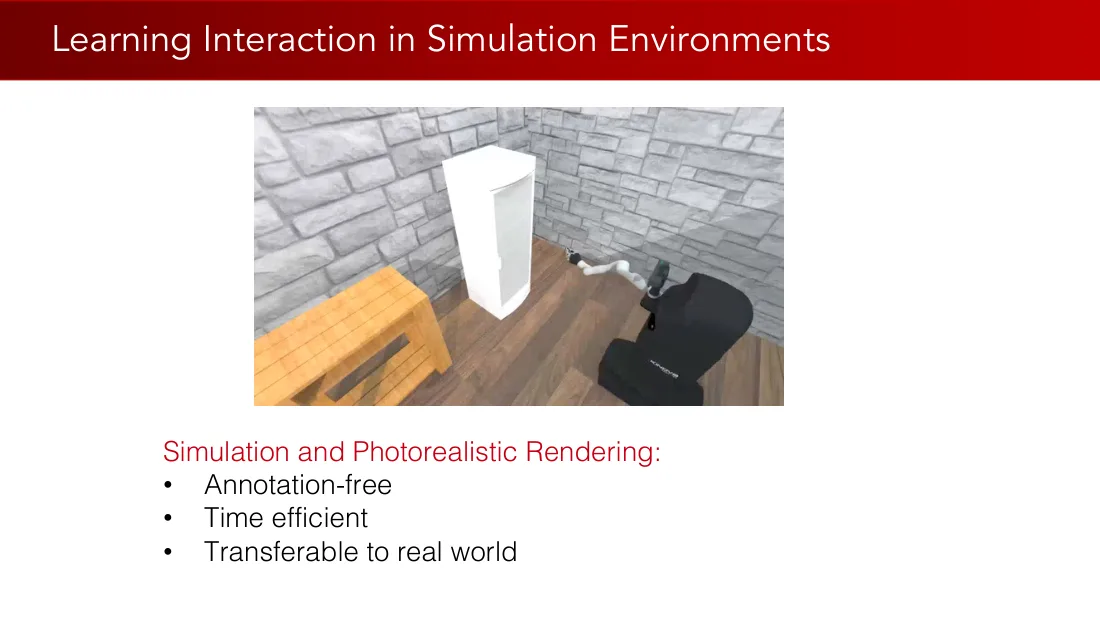
在仿真环境中学习交互

仿真与照片级真实感渲染:

  • 无需标注。
  • 时间效率高。
  • 可迁移到真实世界。

Lecture 01 · PDF p43

Lecture 1 英文原课件第43页
英文原页 · 点击在PDF中查看或放大
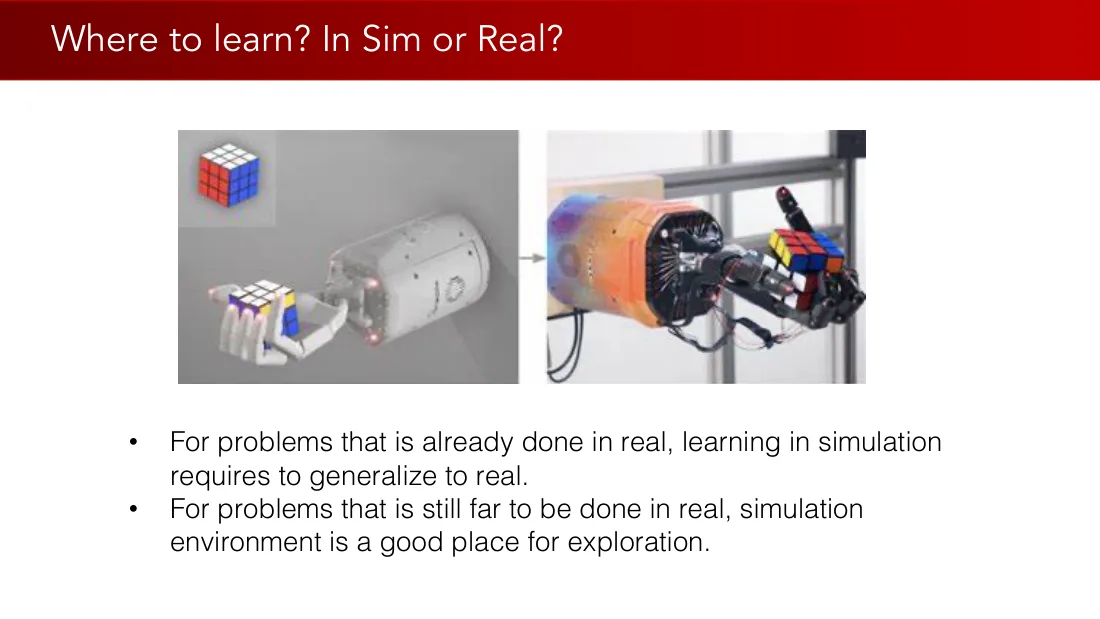
在哪里学习?仿真还是真实世界?
  • 对于已经在真实世界中实现的问题,在仿真中学习需要泛化到真实世界。
  • 对于距离在真实世界中实现还很远的问题,仿真环境是开展探索的好地方。

Lecture 01 · PDF p44

Lecture 1 英文原课件第44页
英文原页 · 点击在PDF中查看或放大
具身智能

Lecture 01 · PDF p45

Lecture 1 英文原课件第45页
英文原页 · 点击在PDF中查看或放大
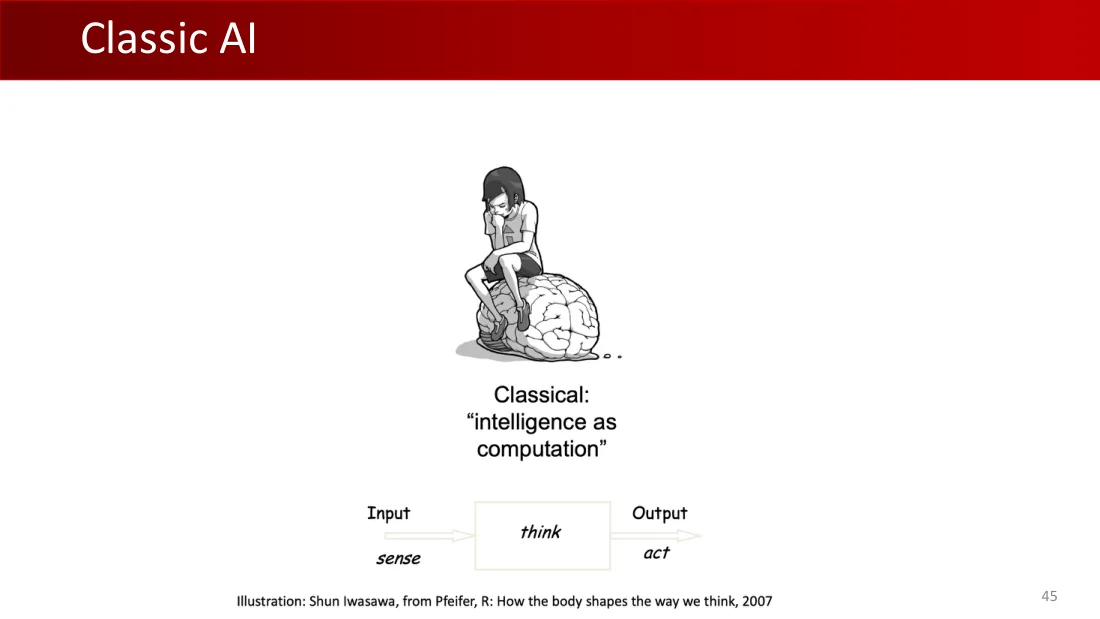
经典人工智能

经典观点:“智能即计算”。

输入;感知 → 思考 → 输出;行动。

插画:Shun Iwasawa,出自 Pfeifer, R.《身体如何塑造我们的思考方式》(How the Body Shapes the Way We Think),2007。

Lecture 01 · PDF p46

Lecture 1 英文原课件第46页
英文原页 · 点击在PDF中查看或放大
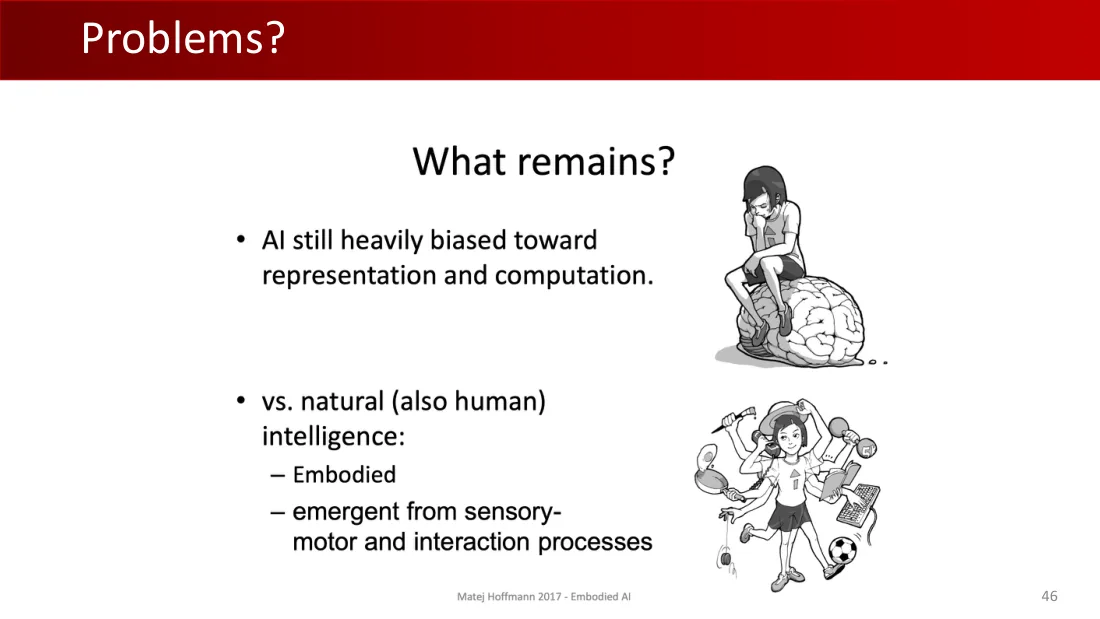
问题?

还缺少什么?

  • 人工智能仍然严重偏重表征与计算。
  • 相比之下,自然智能(也包括人类智能):
    • 是具身的。
    • 从感觉—运动及交互过程中涌现。

Matej Hoffmann,2017,《具身智能》。

Lecture 01 · PDF p47

Lecture 1 英文原课件第47页
英文原页 · 点击在PDF中查看或放大
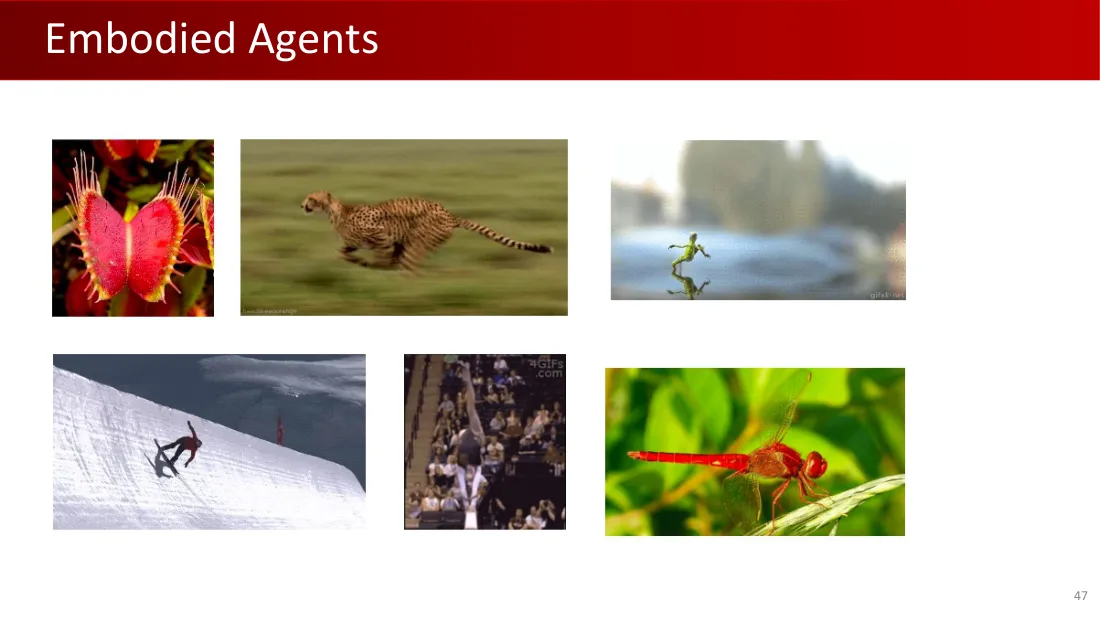
具身智能体

Lecture 01 · PDF p48

Lecture 1 英文原课件第48页
英文原页 · 点击在PDF中查看或放大
具身性
  • “智能需要一个身体”。
  • 相互作用/任务分配。
    • 大脑。
    • 身体(形态——形状、材料……)。
    • 环境。
  • 生态平衡原则。
    • 感觉、运动与神经系统的复杂程度相匹配。

Lecture 01 · PDF p49

Lecture 1 英文原课件第49页
英文原页 · 点击在PDF中查看或放大
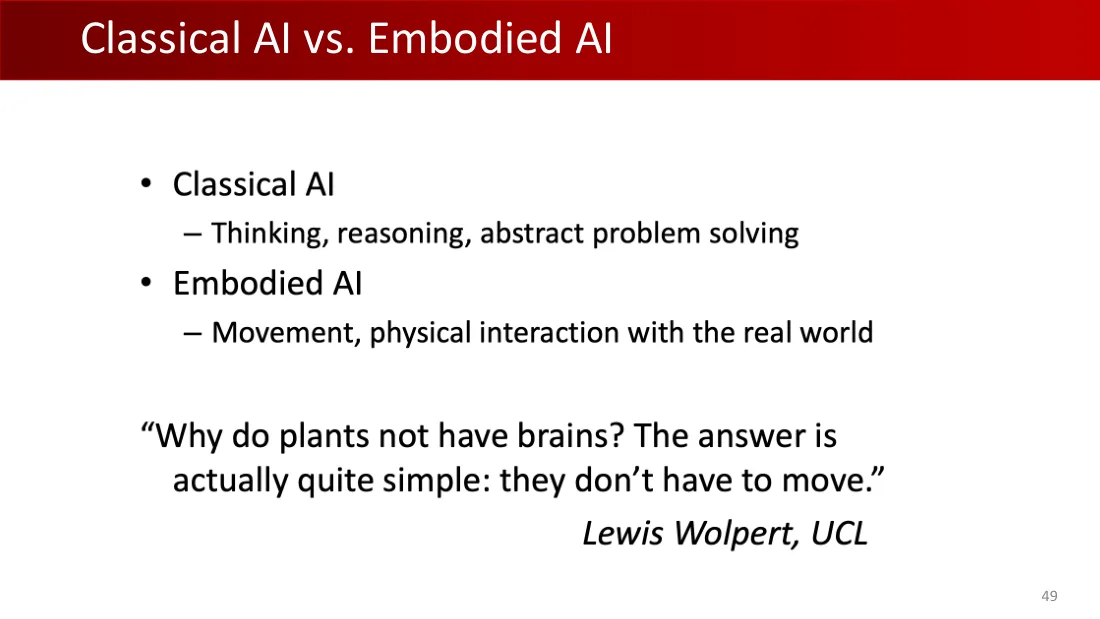
经典人工智能与具身智能的比较
  • 经典人工智能。
    • 思考、推理、解决抽象问题。
  • 具身智能。
    • 运动,以及与真实世界的物理交互。

“植物为什么没有大脑?答案其实很简单:它们不需要移动。”

Lewis Wolpert,伦敦大学学院(UCL)。

Lecture 01 · PDF p50

Lecture 1 英文原课件第50页
英文原页 · 点击在PDF中查看或放大
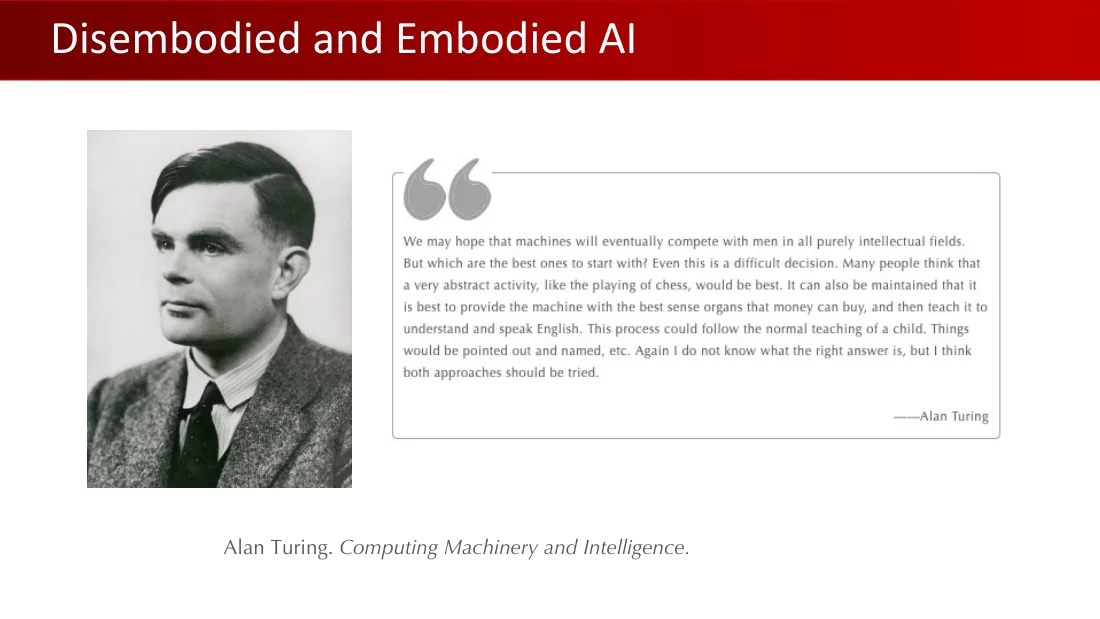
非具身人工智能与具身人工智能

“我们可以希望,机器最终将在所有纯粹智力领域与人类竞争。但是,最好从哪些领域开始呢?这是一个困难的决定。许多人认为,像下棋这样非常抽象的活动最合适。也可以主张,最好给机器配备金钱所能买到的最佳感觉器官,然后教它理解和说英语。这一过程可以仿照通常教导儿童的方式。人们可以指给它看各种事物,并说出它们的名称,等等。再次说明,我不知道正确答案是什么,但我认为两种途径都应该尝试。”

——Alan Turing(艾伦·图灵)。

Alan Turing,《计算机器与智能》(Computing Machinery and Intelligence)。

Lecture 01 · PDF p51

Lecture 1 英文原课件第51页
英文原页 · 点击在PDF中查看或放大
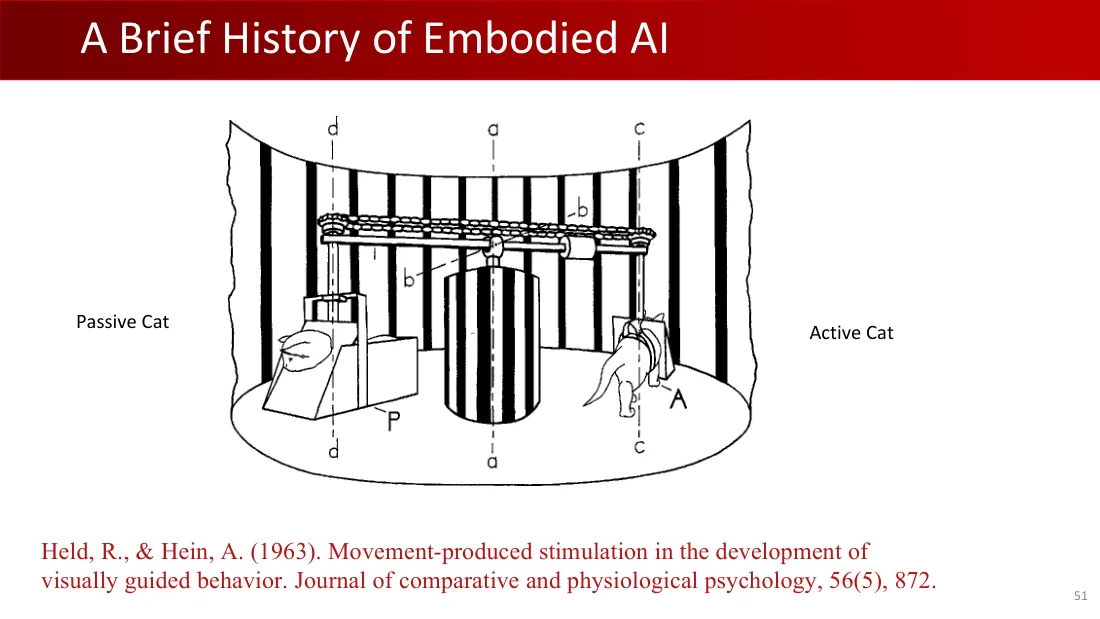
具身智能简史

被动猫;主动猫。

Held, R., & Hein, A.(1963)。《视觉引导行为发展中的运动所产生的刺激》(Movement-produced stimulation in the development of visually guided behavior)。《比较与生理心理学杂志》(Journal of Comparative and Physiological Psychology),56(5),872。

Lecture 01 · PDF p52

Lecture 1 英文原课件第52页
英文原页 · 点击在PDF中查看或放大
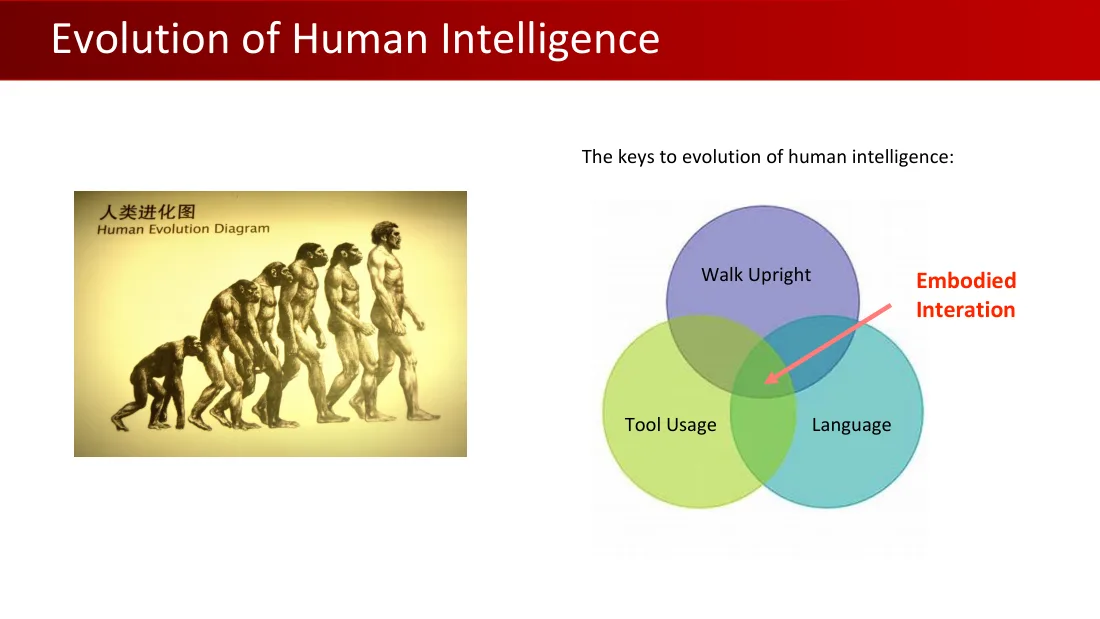
人类智能的演化

人类智能演化的关键:

直立行走;工具使用;语言;具身交互。

Lecture 01 · PDF p53

Lecture 1 英文原课件第53页
英文原页 · 点击在PDF中查看或放大
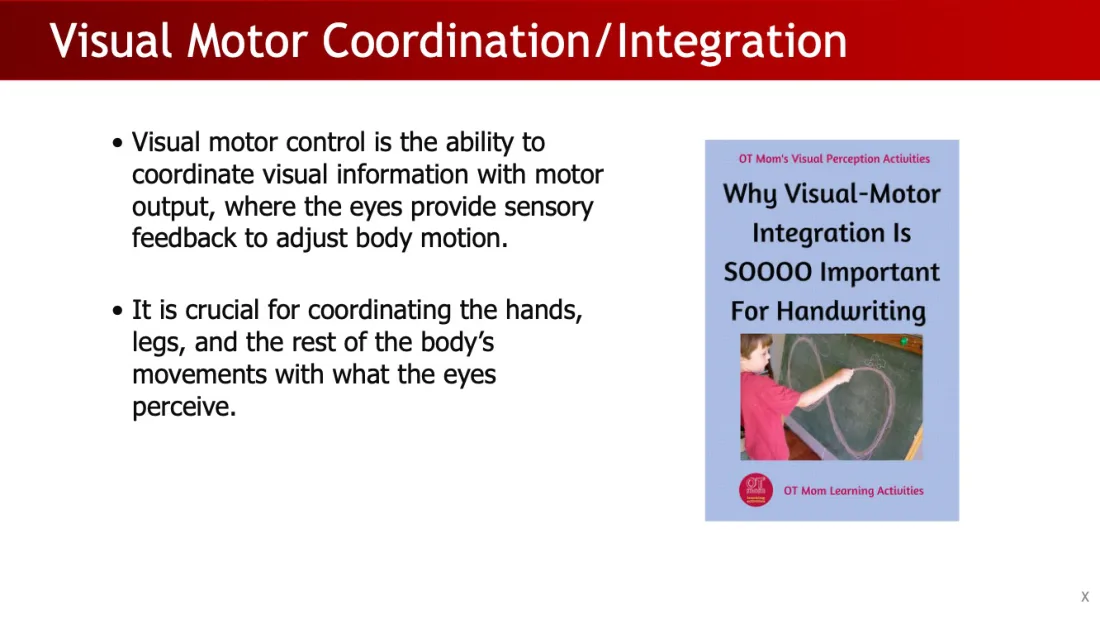
视觉运动协调/整合
  • 视觉运动控制是协调视觉信息与运动输出的能力,在这个过程中,眼睛提供感觉反馈来调整身体运动。
  • 它对协调双手、双腿和身体其他部位的运动与眼睛所感知的信息至关重要。

OT Mom 的视觉感知活动。

为什么视觉运动整合对手写如此重要。

OT Mom 学习活动。

Lecture 01 · PDF p54

Lecture 1 英文原课件第54页
英文原页 · 点击在PDF中查看或放大
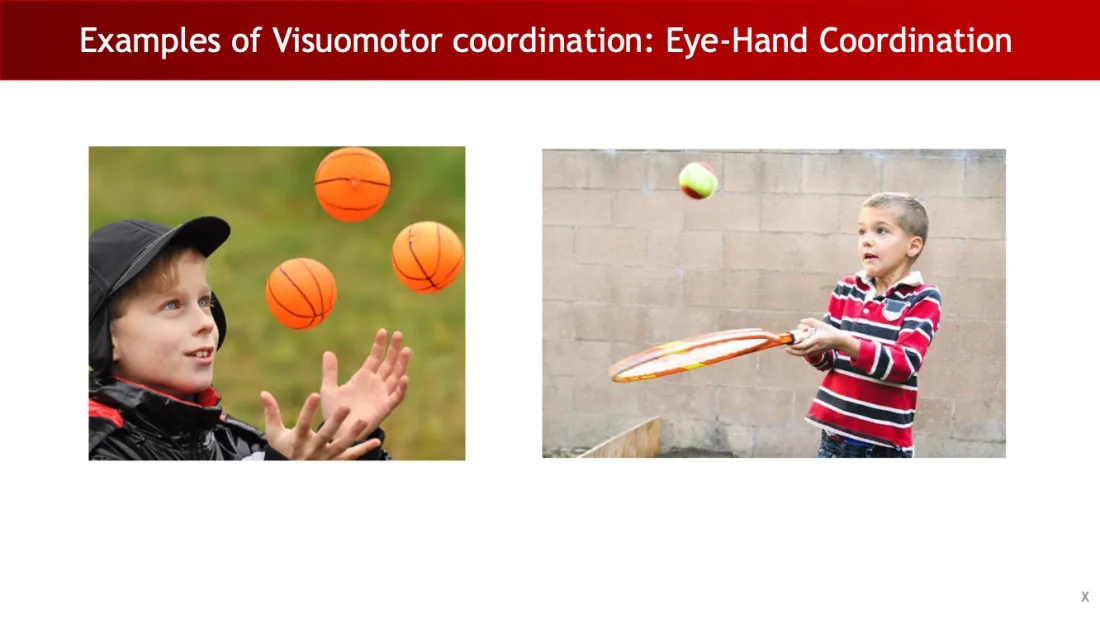
手眼协调

Lecture 01 · PDF p55

Lecture 1 英文原课件第55页
英文原页 · 点击在PDF中查看或放大
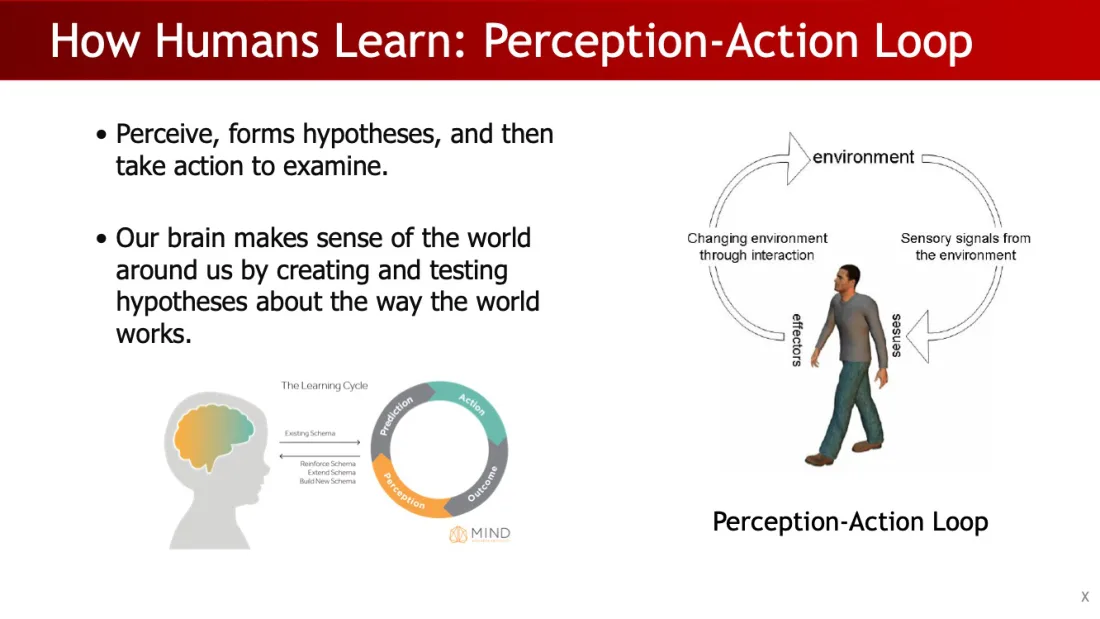
人类如何学习:感知—行动闭环
  • 感知,形成假设,然后采取行动检验。
  • 我们的大脑通过创建并检验关于世界如何运行的假设,理解周围的世界。

学习循环:预测 → 行动 → 结果 → 感知。

已有图式;强化图式、扩展图式、构建新图式。

MIND 研究所。

感知—行动闭环:环境;通过交互改变环境;来自环境的感觉信号;效应器;感官。

Lecture 01 · PDF p56

Lecture 1 英文原课件第56页
英文原页 · 点击在PDF中查看或放大
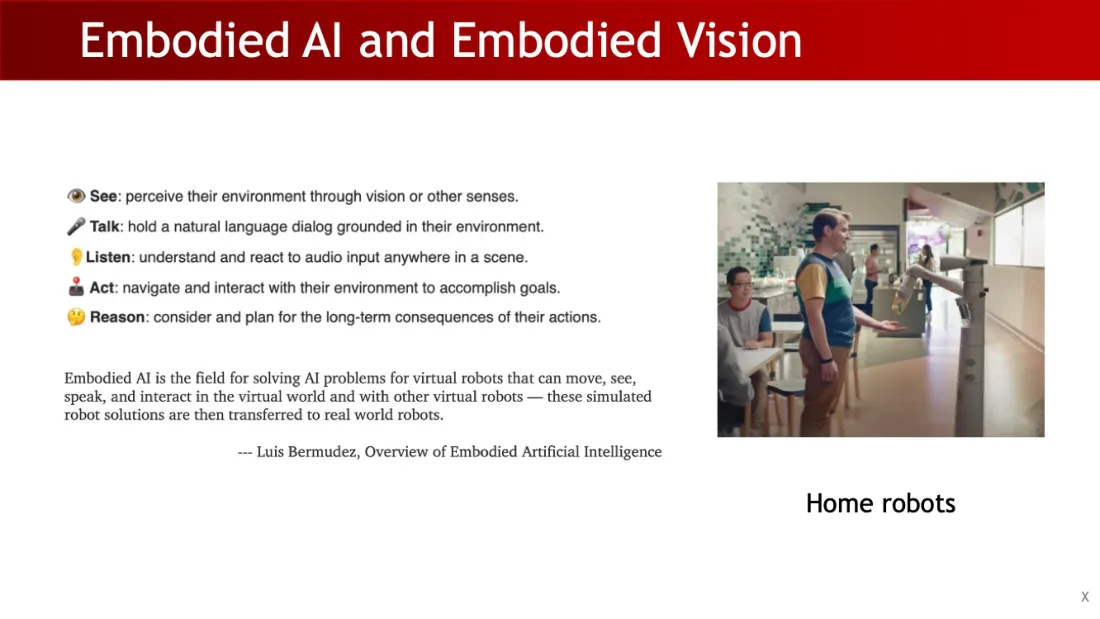
具身智能与具身视觉

看:通过视觉或其他感官感知环境。

说:进行以所在环境为基础的自然语言对话。

听:理解场景中任何位置的声音输入,并作出反应。

行动:在环境中导航并与环境交互,以完成目标。

推理:考虑并规划其行动的长期后果。

具身智能是为虚拟机器人解决人工智能问题的领域。这些机器人能够移动、看、说,并在虚拟世界中及与其他虚拟机器人交互——随后,这些模拟机器人的解决方案被迁移到真实世界机器人。

——Luis Bermudez,《具身人工智能概览》(Overview of Embodied Artificial Intelligence)。

家用机器人。

Lecture 01 · PDF p57

Lecture 1 英文原课件第57页
英文原页 · 点击在PDF中查看或放大
课程事务

Lecture 01 · PDF p58

Lecture 1 英文原课件第58页
英文原页 · 点击在PDF中查看或放大
目标:一门具身智能先导课程
  • 一门关于具身智能的前沿课程。
  • 从现代具身智能的视角,涵盖机器人学、基于深度学习的视觉与机器人系统的基础知识。
  • 为开展具身智能研究打下坚实基础。

Lecture 01 · PDF p59

Lecture 1 英文原课件第59页
英文原页 · 点击在PDF中查看或放大
课程事务
  • 授课教师。
    • 王鹤(hewang@pku.edu.cn)。
  • 助教。
    • Haoran Liu(jiangran.lyu@stu.pku.edu.cn)。
    • Hao Shen(dotandung@stu.pku.edu.cn)。
  • 上课时间与地点。
    • 星期一15:10—18:00。
    • 线下:第三教学楼207室。

Lecture 01 · PDF p60

Lecture 1 英文原课件第60页
英文原页 · 点击在PDF中查看或放大
先修要求
  • 课程。
    • 深度学习。
    • 计算机视觉。
    • 大学水平的力学。
  • 编程。
    • 熟练使用 Python。
    • 熟悉 PyTorch。

Lecture 01 · PDF p61

Lecture 1 英文原课件第61页
英文原页 · 点击在PDF中查看或放大
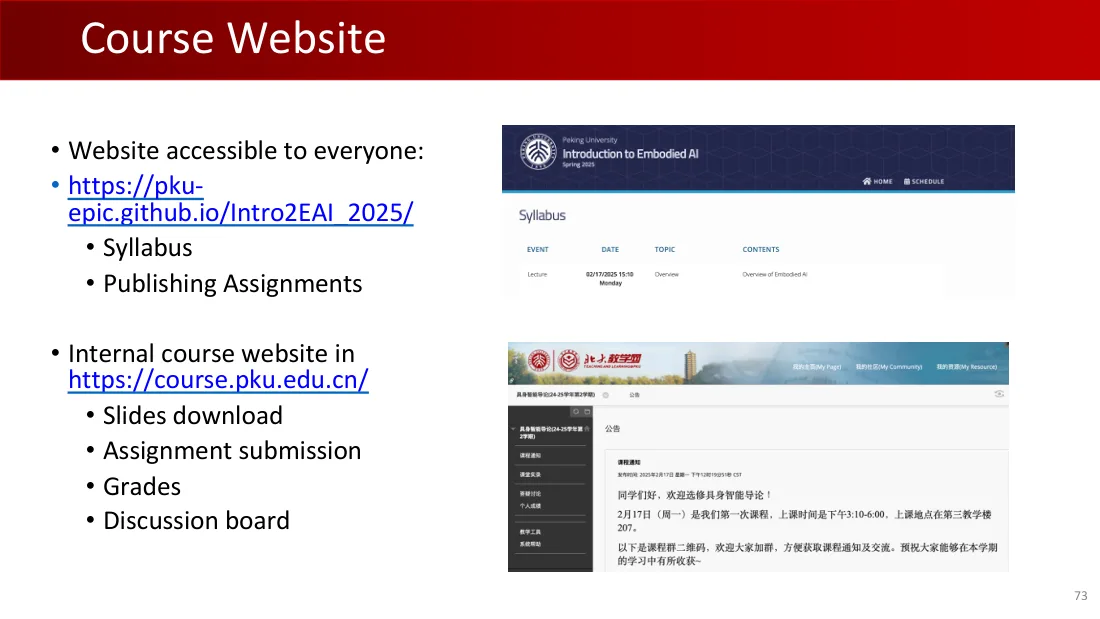
课程网站
  • 人人可访问的网站。
  • https://pku-epic.github.io/Intro2EAI_2025/ 。
    • 教学大纲。
    • 发布作业。
  • 内部课程网站:https://course.pku.edu.cn/ 。
    • 下载幻灯片。
    • 提交作业。
    • 成绩。
    • 讨论区。

网站截图:北京大学;具身智能导论;2025年春季;首页;课程安排;教学大纲。

表头:活动、日期、主题、内容。

授课:2025年2月17日星期一15:10;概览;具身智能概览。

北京大学教学网;我的主页;我的社区;我的资源。

具身智能导论(24—25学年第2学期);公告;课程通知;课堂实录;答疑讨论;个人成绩;教学工具;系统帮助。

课程通知,发布时间2025年2月17日星期一12:19:51 CST。

同学们好,欢迎选修具身智能导论!2月17日(周一)是我们第一次课程,上课时间是下午3:10—6:00,上课地点在第三教学楼207。

以下是课程群二维码,欢迎大家加群,方便获取课程通知及交流。预祝大家能够在本学期的学习中有所收获~

Lecture 01 · PDF p62

Lecture 1 英文原课件第62页
英文原页 · 点击在PDF中查看或放大
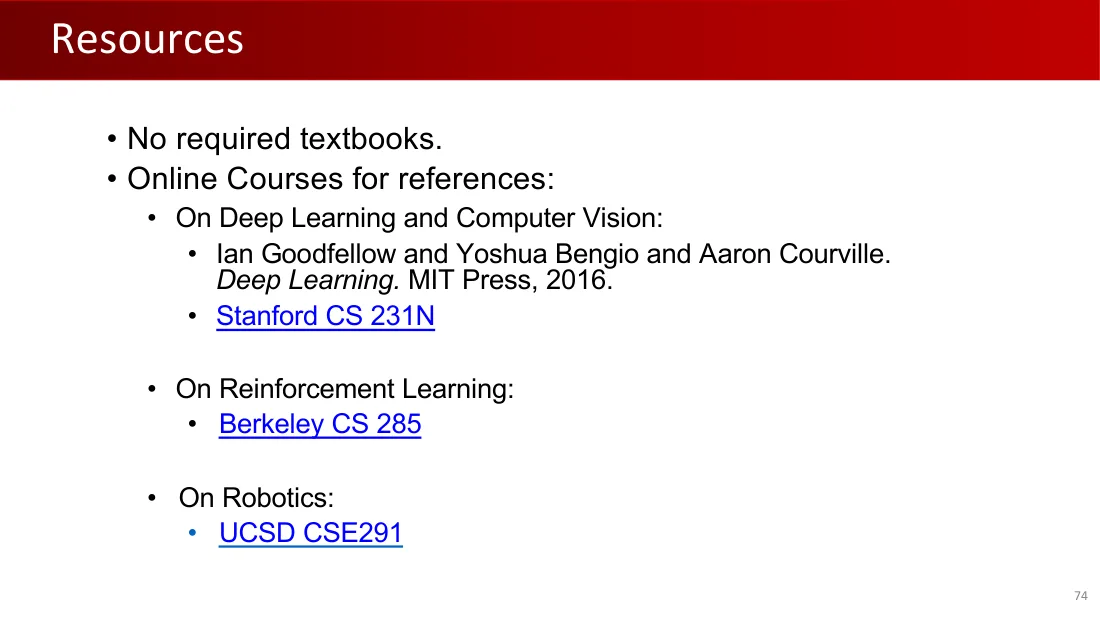
资源
  • 没有指定必读教材。
  • 可参考的在线课程:
    • 深度学习与计算机视觉:
      • Ian Goodfellow、Yoshua Bengio、Aaron Courville,《深度学习》(Deep Learning),MIT Press,2016。
      • 斯坦福大学 CS231n。
    • 强化学习:
      • 加州大学伯克利分校 CS285。
    • 机器人学:
      • 加州大学圣迭戈分校 CSE291。

Lecture 01 · PDF p63

Lecture 1 英文原课件第63页
英文原页 · 点击在PDF中查看或放大
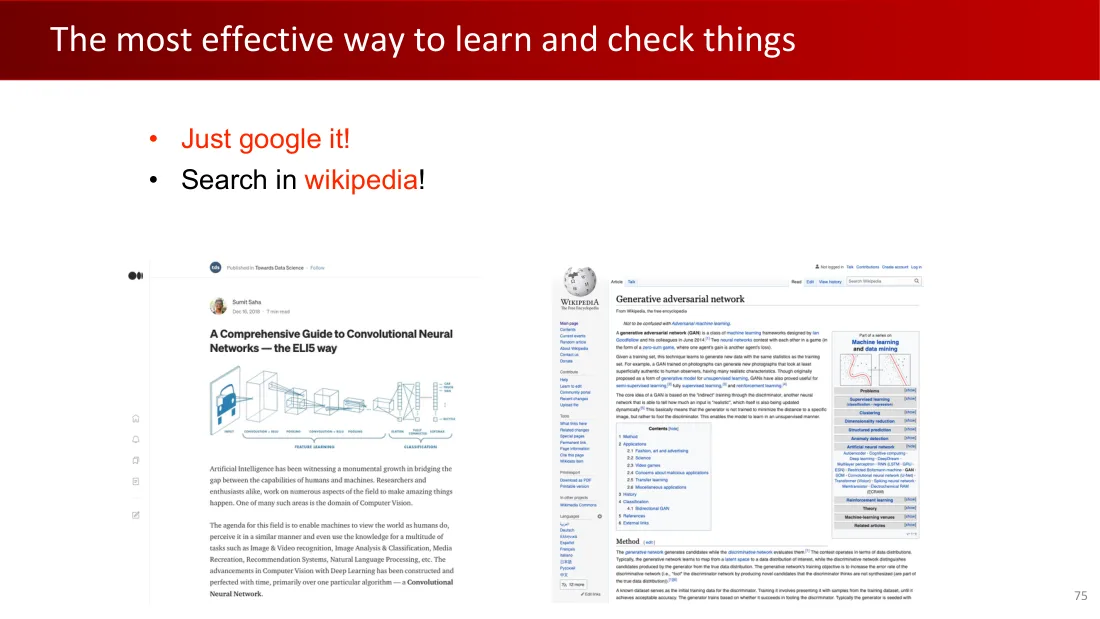
最有效的学习与核查方法
  • 直接用 Google 搜索!
  • 在维基百科中搜索!

发表于 Towards Data Science;关注。

Sumit Saha;2018年12月16日;阅读约需7分钟。

《卷积神经网络全面指南——用五岁孩子也能理解的方式解释》。

输入 → 卷积 + ReLU → 池化 → 卷积 + ReLU → 池化 → 展平 → 全连接 → Softmax。

特征学习;分类。类别:轿车、卡车、厢式货车、……、自行车。

人工智能在缩小人类与机器能力差距方面取得了巨大进展。研究人员和爱好者都在这个领域的许多方面努力,让令人惊叹的事情发生。其中一个领域就是计算机视觉。

这个领域的目标是让机器像人类一样观察世界,以类似方式感知,甚至运用这些知识完成多种任务,例如图像与视频识别、图像分析与分类、媒体再创作、推荐系统、自然语言处理等。随着时间推移,利用深度学习的计算机视觉不断发展和完善,而其中主要依赖的一种算法是卷积神经网络。

维基百科,自由的百科全书。

生成对抗网络。

不应与对抗机器学习混淆。

生成对抗网络(GAN)是一类机器学习框架,由 Ian Goodfellow 及其同事于2014年6月设计。[1] 两个神经网络在博弈中相互竞争(其形式为零和博弈,一个参与者的收益就是另一个参与者的损失)。

给定一个训练集,这种技术学习生成与训练集具有相同统计特征的新数据。例如,在照片上训练的 GAN 能生成新照片,对人类观察者而言至少在表面上显得真实,并具有许多真实感特征。尽管最初被作为无监督学习的一种生成模型提出,GAN 也被证明对半监督学习[2]、全监督学习[3]和强化学习[4]有用。

GAN 的核心思想是通过判别器进行“间接”训练。判别器是另一个神经网络,能够判断输入有多“真实”,而判别器本身也会动态更新。[5] 这意味着生成器并不是通过最小化与某一特定图像的距离来训练,而是要欺骗判别器。这使模型能够以无监督方式学习。

目录(隐藏):1 方法;2 应用;2.1 时尚、艺术和广告;2.2 科学;2.3 电子游戏;2.4 对恶意应用的担忧;2.5 迁移学习;2.6 其他应用;3 历史;4 分类;4.1 双向 GAN;5 参考文献;6 外部链接。

方法(编辑)。

生成网络生成候选数据,而判别网络评估它们。[1] 这种竞争是在数据分布层面进行的。通常,生成网络学习从潜在空间映射到所关心的数据分布,而判别网络区分生成器产生的候选数据和真实数据分布。生成网络的训练目标是提高判别网络的错误率,即通过生成新候选数据来“欺骗”判别网络,让它认为这些候选数据不是合成的,而是真实数据分布的一部分。[1][6]

已知数据集作为判别器的初始训练数据。训练中不断向判别器提供训练集样本,直到它达到可接受的准确率。生成器则根据是否成功欺骗判别器而训练。通常,生成器以…

页面功能:未登录;讨论;贡献;创建账户;登录;条目;讨论;阅读;编辑;查看历史;搜索维基百科。

左侧导航:首页;目录;时事;随机条目;关于维基百科;联系我们;捐赠;贡献;帮助;学习编辑;社群入口;最近更改;上传文件;工具;链入页面;相关更改;特殊页面;永久链接;页面信息;引用本页;维基数据项目;打印/导出;下载为 PDF;可打印版本;其他项目;维基共享资源;语言;更多12种;编辑链接。

右侧系列:机器学习与数据挖掘。

问题;监督学习(分类、回归);聚类;降维;结构化预测;异常检测;人工神经网络。

自编码器;认知计算;深度学习;DeepDream;多层感知机;循环神经网络(LSTM、GRU、ESN);受限玻尔兹曼机;GAN;自组织映射;卷积神经网络(U-Net);Transformer(视觉);脉冲神经网络;忆阻器;电化学随机存取存储器(ECRAM)。

强化学习;理论;机器学习发表平台;相关文章;显示;隐藏;查看、讨论、编辑。

Lecture 01 · PDF p64

Lecture 1 英文原课件第64页
英文原页 · 点击在PDF中查看或放大
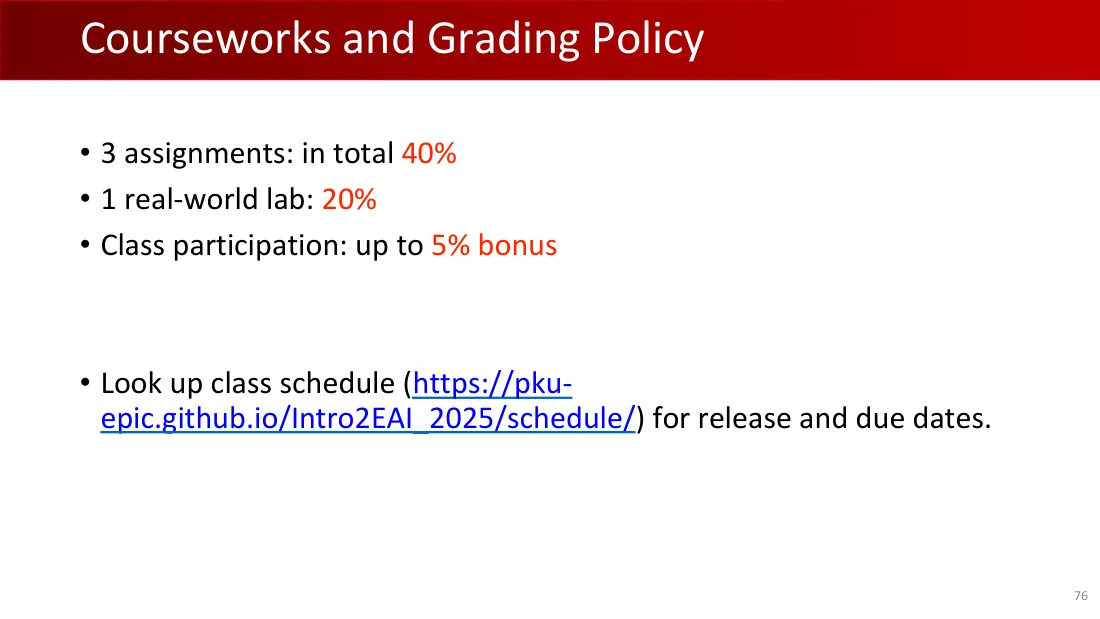
课程作业与评分政策
  • 3次作业:合计40%。
  • 1次真实世界实验:20%。
  • 课堂参与:最多额外加5%。
  • 发布和截止日期请查课程安排:https://pku-epic.github.io/Intro2EAI_2025/schedule/ 。

Lecture 01 · PDF p65

Lecture 1 英文原课件第65页
英文原页 · 点击在PDF中查看或放大
作业
  • 每次作业有两周完成时间。
  • 作业迟交政策。
    • 截止后1天(0—24小时)内,扣10%。
    • 截止后2天(24—48小时)内,扣20%。
    • 超过2天,记零分。

Lecture 01 · PDF p66

Lecture 1 英文原课件第66页
英文原页 · 点击在PDF中查看或放大
微信群
  • 微信群。
    • 用于通知和公告。

群聊二维码;具身智能导论;微信扫一扫加入群聊;二维码有效期。

Lecture 01 · PDF p67

Lecture 1 英文原课件第67页
英文原页 · 点击在PDF中查看或放大
课程安排

Lecture 01 · PDF p68

Lecture 1 英文原课件第68页
英文原页 · 点击在PDF中查看或放大
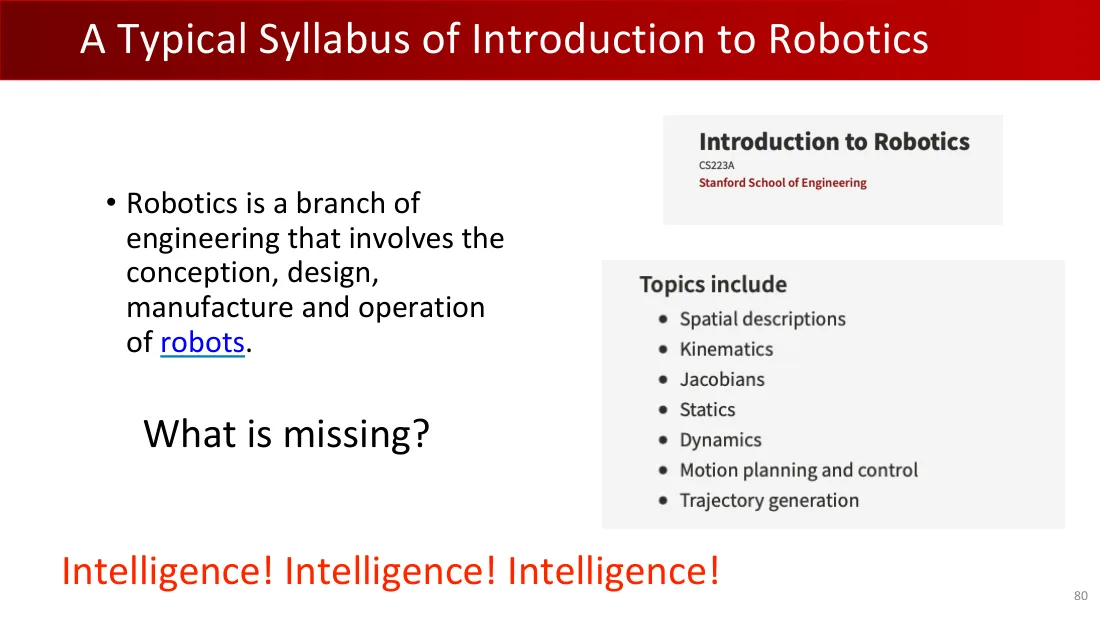
典型的机器人学导论教学大纲
  • 机器人学是工程学的一个分支,涉及机器人的构思、设计、制造和运行。

缺少了什么?

智能!智能!智能!

机器人学导论,CS223A,斯坦福大学工程学院。

内容包括:空间描述;运动学;雅可比矩阵;静力学;动力学;运动规划与控制;轨迹生成。

Lecture 01 · PDF p69

Lecture 1 英文原课件第69页
英文原页 · 点击在PDF中查看或放大
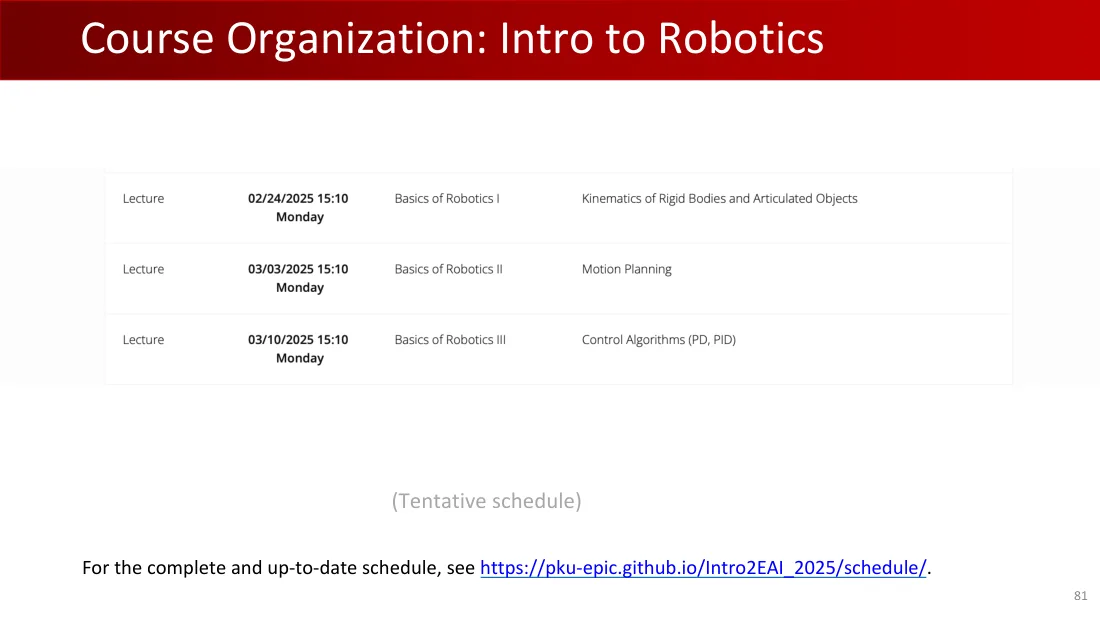
课程安排:机器人学导论
活动日期与时间主题内容
授课2025年2月24日 星期一15:10机器人学基础 I刚体和关节物体的运动学
授课2025年3月3日 星期一15:10机器人学基础 II运动规划
授课2025年3月10日 星期一15:10机器人学基础 III控制算法(PD、PID)

(暂定安排)

完整且最新的安排见 https://pku-epic.github.io/Intro2EAI_2025/schedule/。

Lecture 01 · PDF p70

Lecture 1 英文原课件第70页
英文原页 · 点击在PDF中查看或放大
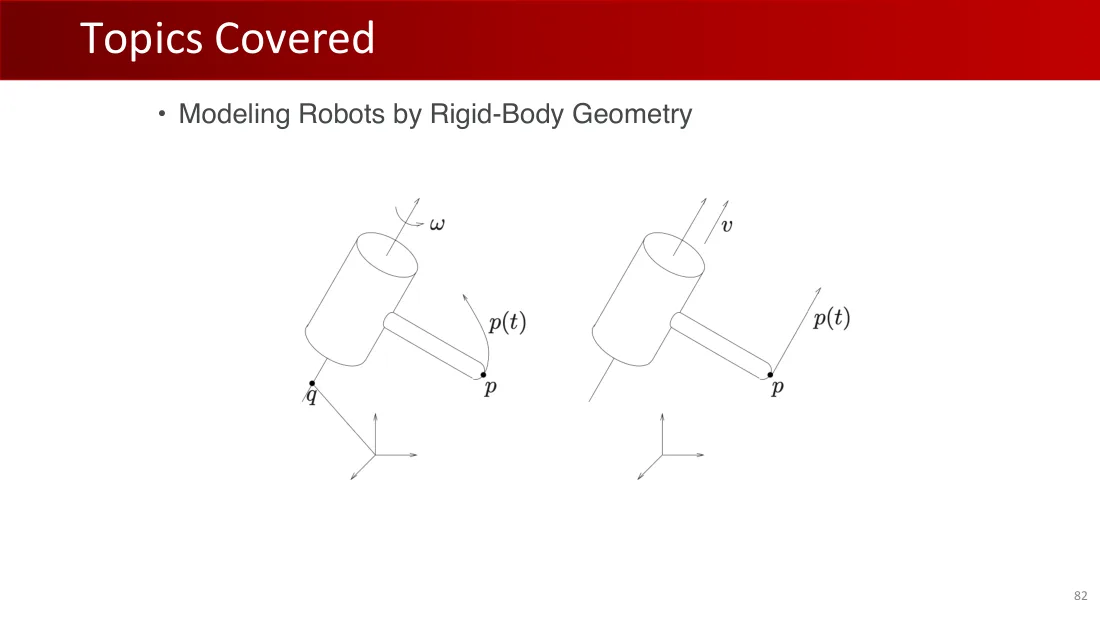
涵盖的主题
  • 用刚体几何建模机器人。

Lecture 01 · PDF p71

Lecture 1 英文原课件第71页
英文原页 · 点击在PDF中查看或放大
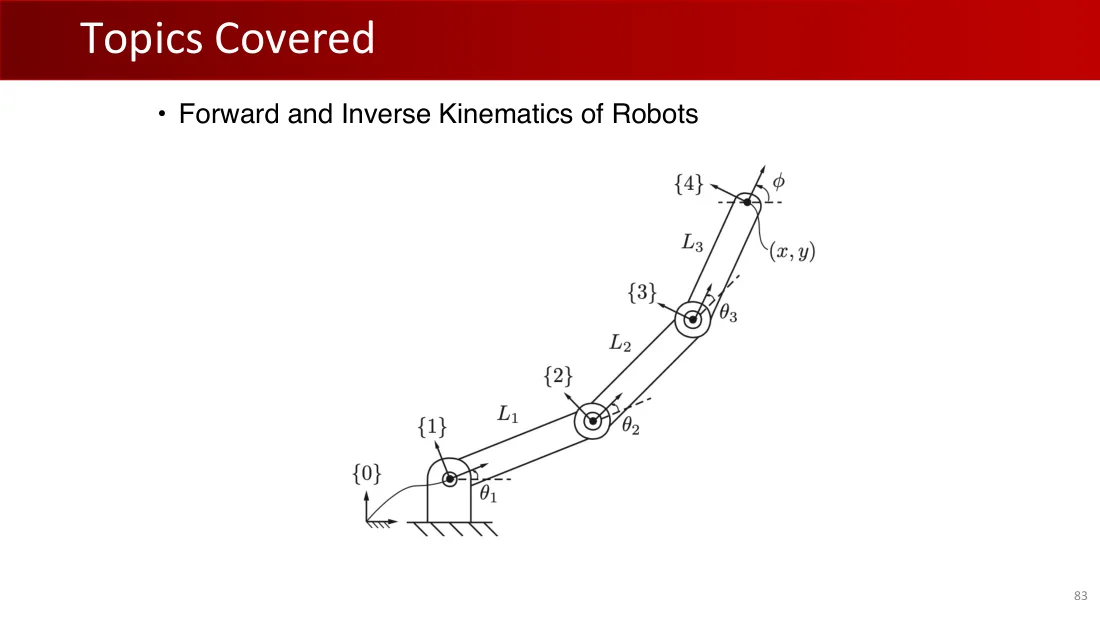
涵盖的主题
  • 机器人的正向和逆向运动学。

图中:第1轴、第2轴、第3轴、第4轴、第5轴、第6轴;正向运动学(FK)解;逆向运动学(IK)解;KUKA。

Lecture 01 · PDF p72

Lecture 1 英文原课件第72页
英文原页 · 点击在PDF中查看或放大
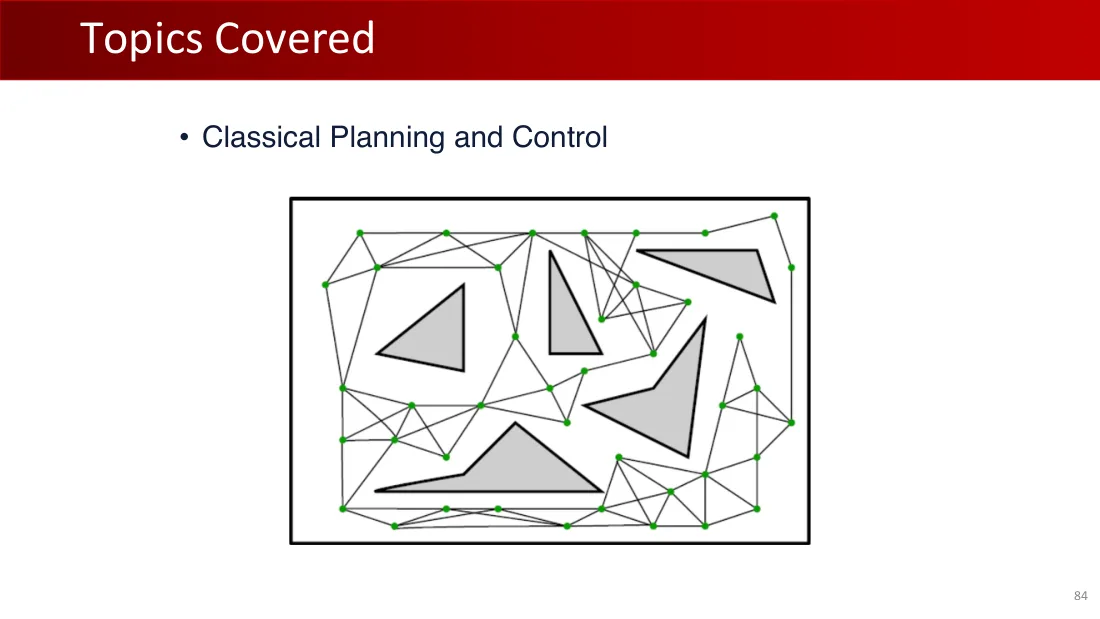
涵盖的主题
  • 经典规划与控制。

Lecture 01 · PDF p73

Lecture 1 英文原课件第73页
英文原页 · 点击在PDF中查看或放大
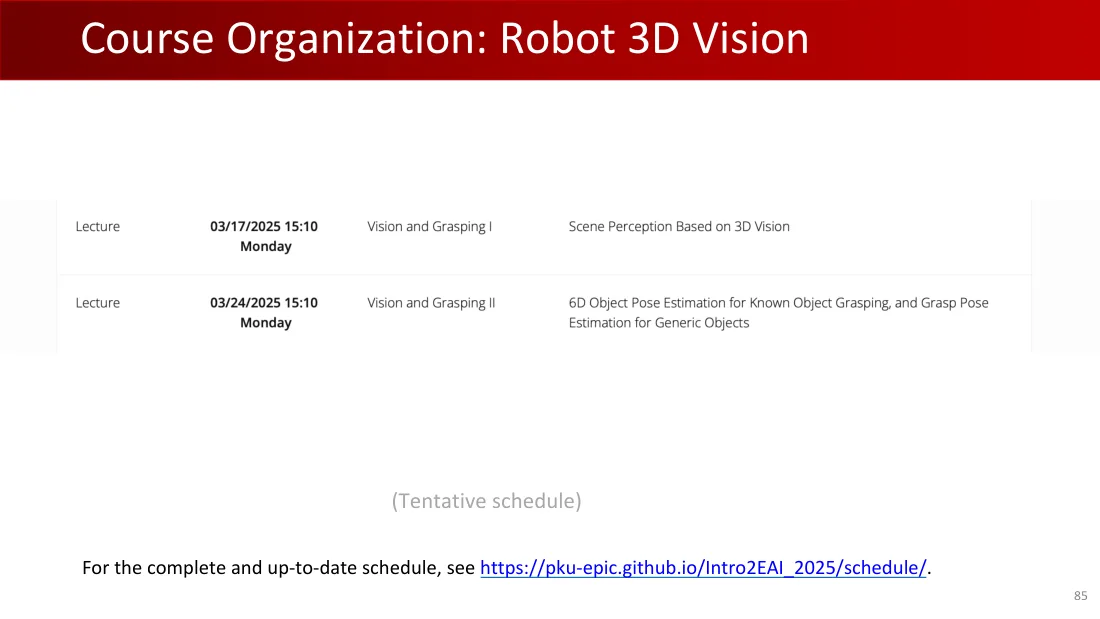
课程安排:机器人三维视觉
活动日期与时间主题内容
授课2025年3月17日 星期一15:10视觉与抓取 I基于三维视觉的场景感知
授课2025年3月24日 星期一15:10视觉与抓取 II用于已知物体抓取的六维物体位姿估计,以及通用物体的抓取位姿估计

(暂定安排)

完整且最新的安排见 https://pku-epic.github.io/Intro2EAI_2025/schedule/。

Lecture 01 · PDF p74

Lecture 1 英文原课件第74页
英文原页 · 点击在PDF中查看或放大
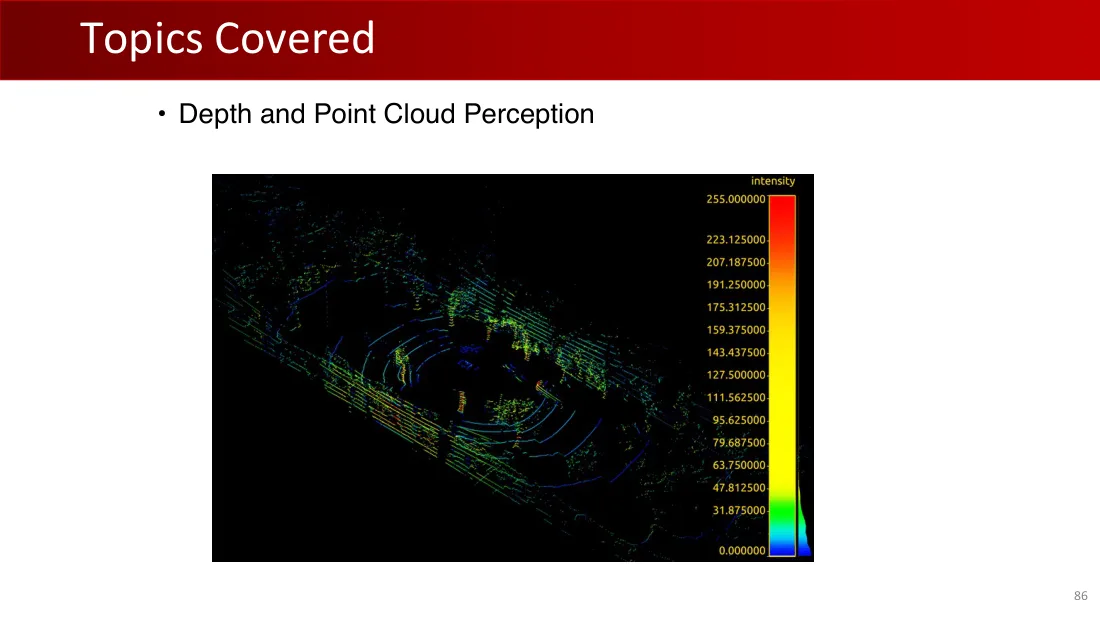
涵盖的主题
  • 深度与点云感知。

灰度强度:0—255。

Lecture 01 · PDF p75

Lecture 1 英文原课件第75页
英文原页 · 点击在PDF中查看或放大
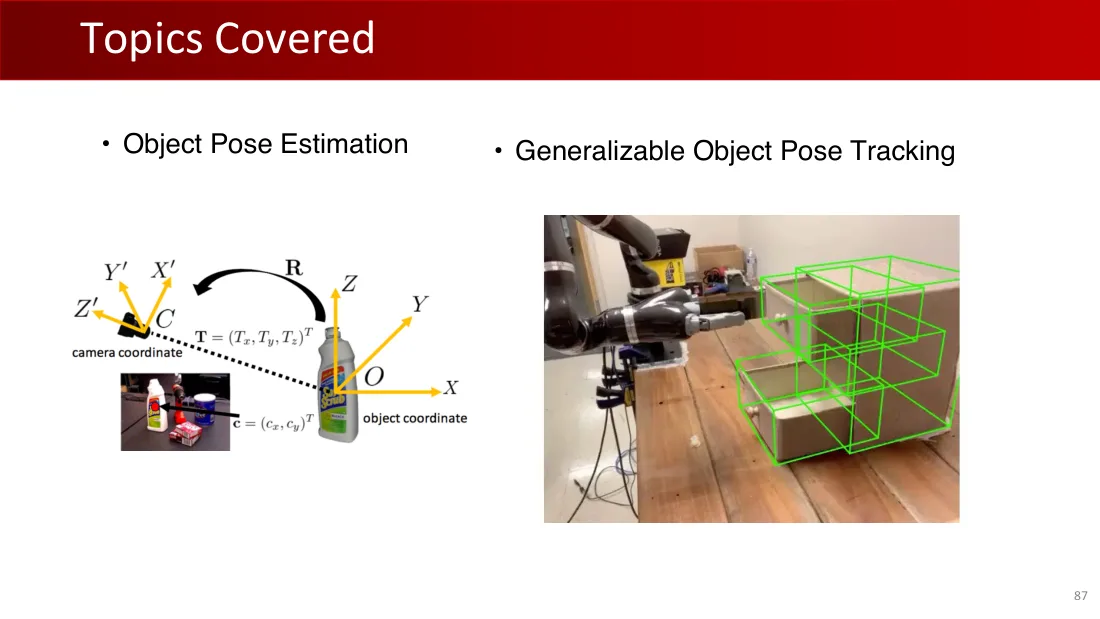
涵盖的主题
  • 物体位姿估计。
  • 可泛化的物体位姿跟踪。

相机坐标系;物体坐标系;旋转 R;平移 T。

Lecture 01 · PDF p76

Lecture 1 英文原课件第76页
英文原页 · 点击在PDF中查看或放大
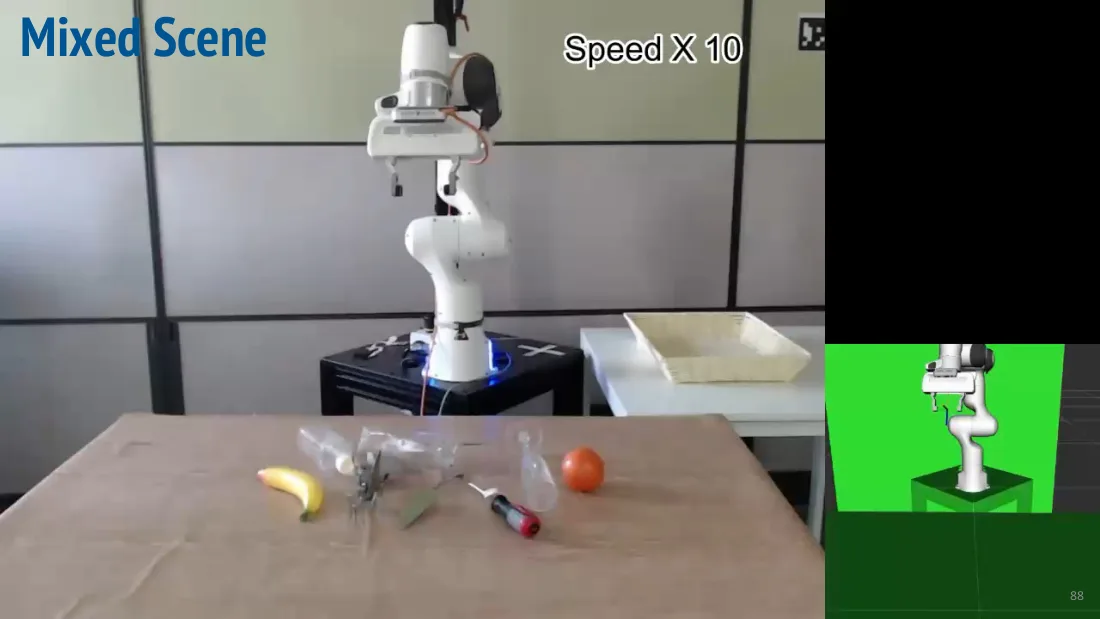
混合场景

10倍速。

Lecture 01 · PDF p77

Lecture 1 英文原课件第77页
英文原页 · 点击在PDF中查看或放大
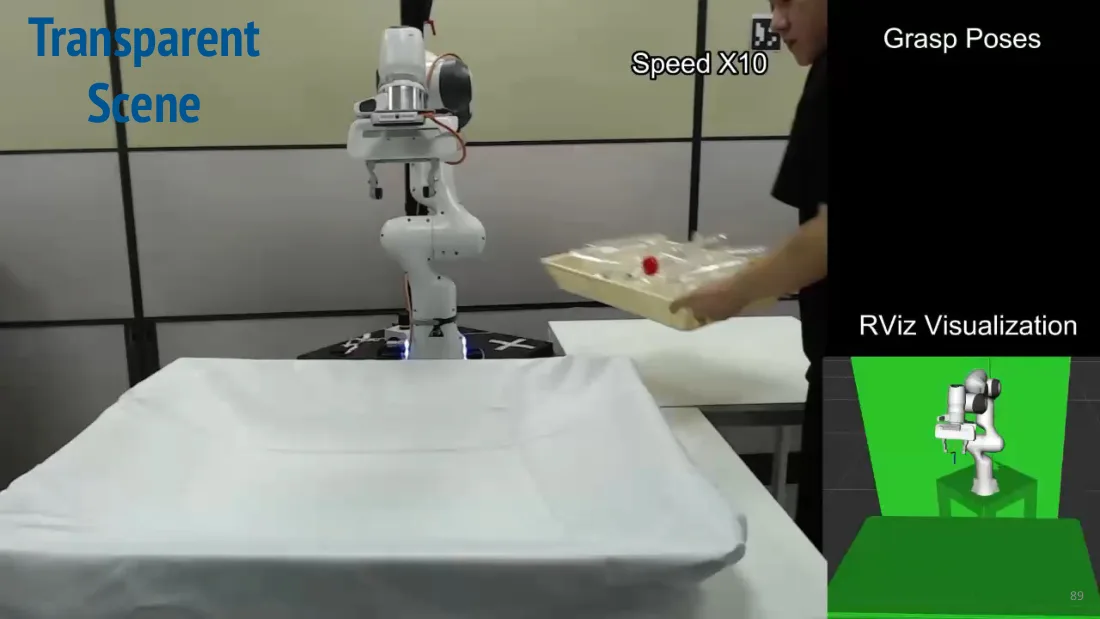
透明物体场景

10倍速;抓取位姿;RViz 可视化。

Lecture 01 · PDF p78

Lecture 1 英文原课件第78页
英文原页 · 点击在PDF中查看或放大
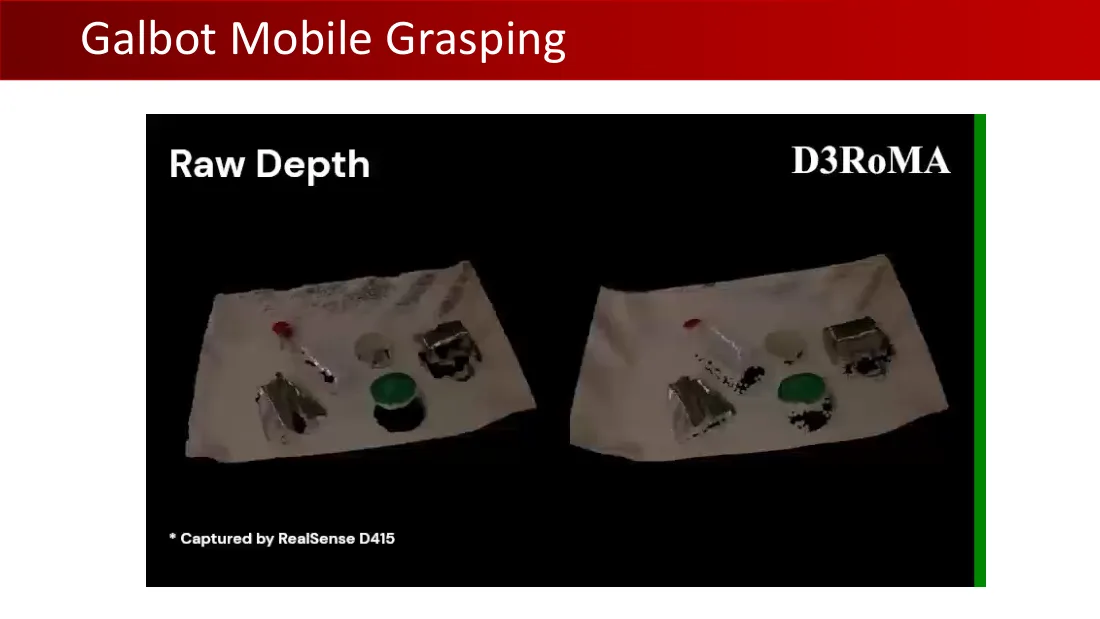
Galbot 移动抓取

原始深度;D3RoMa;由 RealSense D415 拍摄。

Lecture 01 · PDF p79

Lecture 1 英文原课件第79页
英文原页 · 点击在PDF中查看或放大
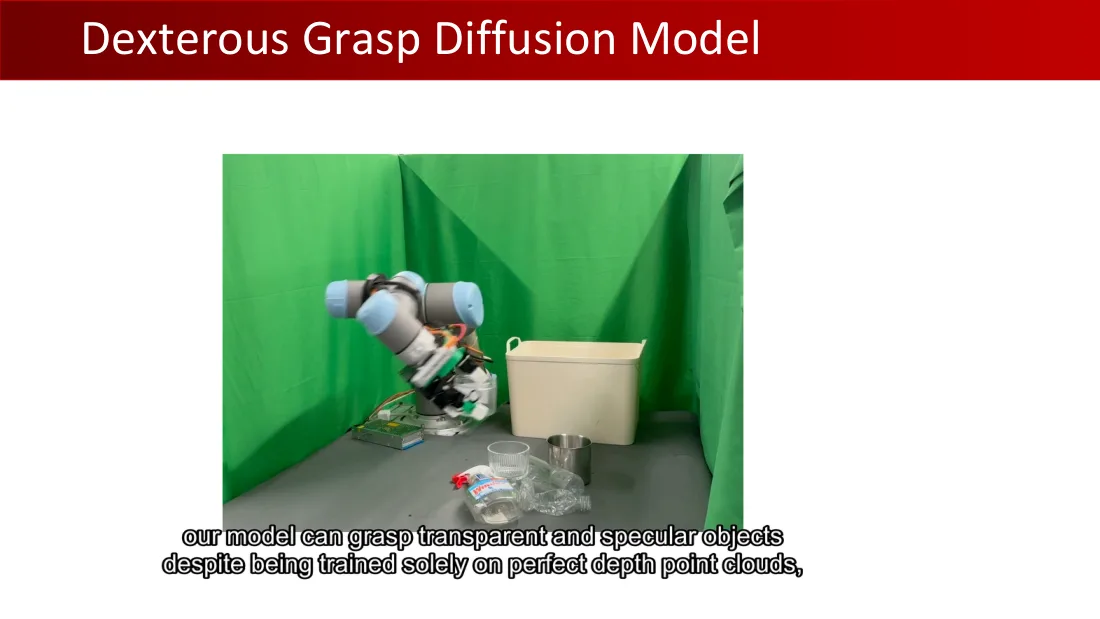
灵巧抓取扩散模型

我们的模型即使只在完美深度点云上训练,也能抓取透明和镜面物体。

Lecture 01 · PDF p80

Lecture 1 英文原课件第80页
英文原页 · 点击在PDF中查看或放大
中文翻译

Lecture 01 · PDF p81

Lecture 1 英文原课件第81页
英文原页 · 点击在PDF中查看或放大
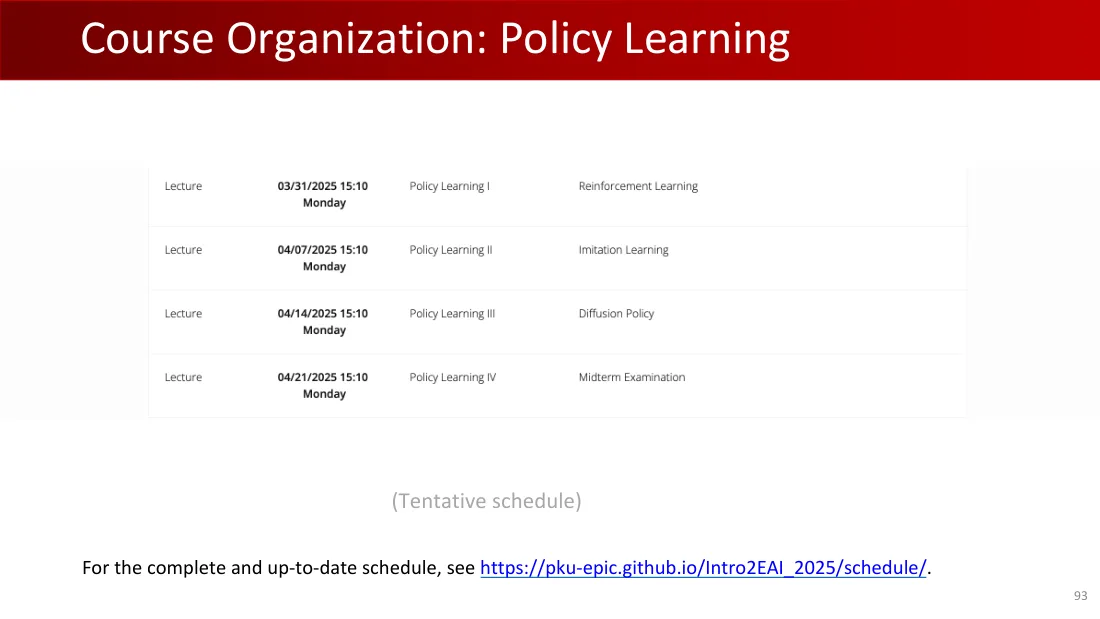
课程安排:策略学习
活动日期与时间主题内容
授课2025年3月31日 星期一15:10策略学习 I强化学习
授课2025年4月7日 星期一15:10策略学习 II模仿学习
授课2025年4月14日 星期一15:10策略学习 III扩散策略
授课2025年4月21日 星期一15:10策略学习 IV期中考试

(暂定安排)

完整且最新的安排见 https://pku-epic.github.io/Intro2EAI_2025/schedule/。

Lecture 01 · PDF p82

Lecture 1 英文原课件第82页
英文原页 · 点击在PDF中查看或放大
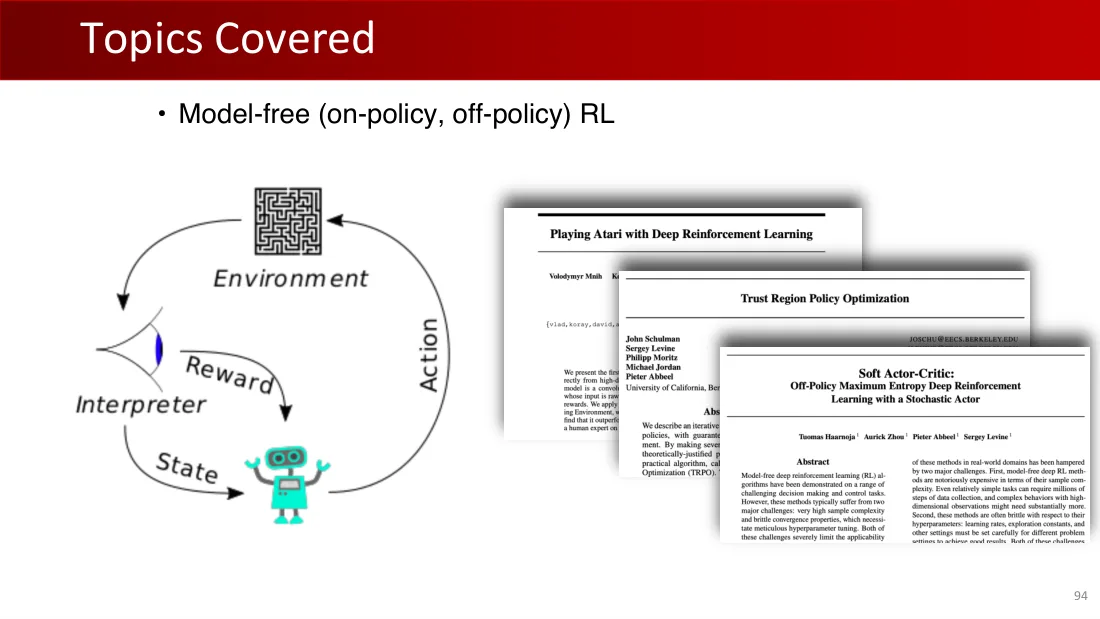
涵盖的主题
  • 无模型强化学习(同策略、异策略)。

环境;解释器;奖励;状态;动作。

《用深度强化学习玩 Atari 游戏》(Playing Atari with Deep Reinforcement Learning)。

Volodymyr Mnih;Kor…;{vlad, koray, david, a…}。

我们提出首个…;直接从高维…;模型是卷积…;其输入是原始…;奖励。我们应用…;在环境中,我们…;发现它优于…;人类专家在…

《信赖域策略优化》(Trust Region Policy Optimization)。

John Schulman;Sergey Levine;Philipp Moritz;Michael Jordan;Pieter Abbeel。

加州大学伯克利分校;JOSCHU@EECS.BERKELEY.EDU。

摘要:我们描述一种迭代…;策略,具有保证…;改进。通过做出若干…;有理论依据的…;实用算法,称为…;优化(TRPO)。

《Soft Actor-Critic:使用随机 Actor 的异策略最大熵深度强化学习》。

Tuomas Haarnoja¹;Aurick Zhou¹;Pieter Abbeel¹;Sergey Levine¹。

摘要:无模型深度强化学习(RL)算法已在一系列有挑战性的决策与控制任务中得到验证。然而,这些方法通常面临两个主要挑战:样本复杂度很高,以及收敛性质脆弱,这使得超参数需要细致调节。这两个挑战都严重限制了这些方法的适用性…

…这些方法在真实世界领域中的应用受到两个主要挑战的阻碍。首先,无模型深度强化学习方法的样本复杂度成本很高。即使相对简单的任务也可能需要数百万步数据采集,而具有高维观测的复杂行为可能需要更多。其次,这些方法通常对超参数很敏感:学习率、探索常数以及其他设置必须针对不同问题设置仔细调节,才能得到良好结果。这两个挑战…

Lecture 01 · PDF p83

Lecture 1 英文原课件第83页
英文原页 · 点击在PDF中查看或放大
涵盖的主题
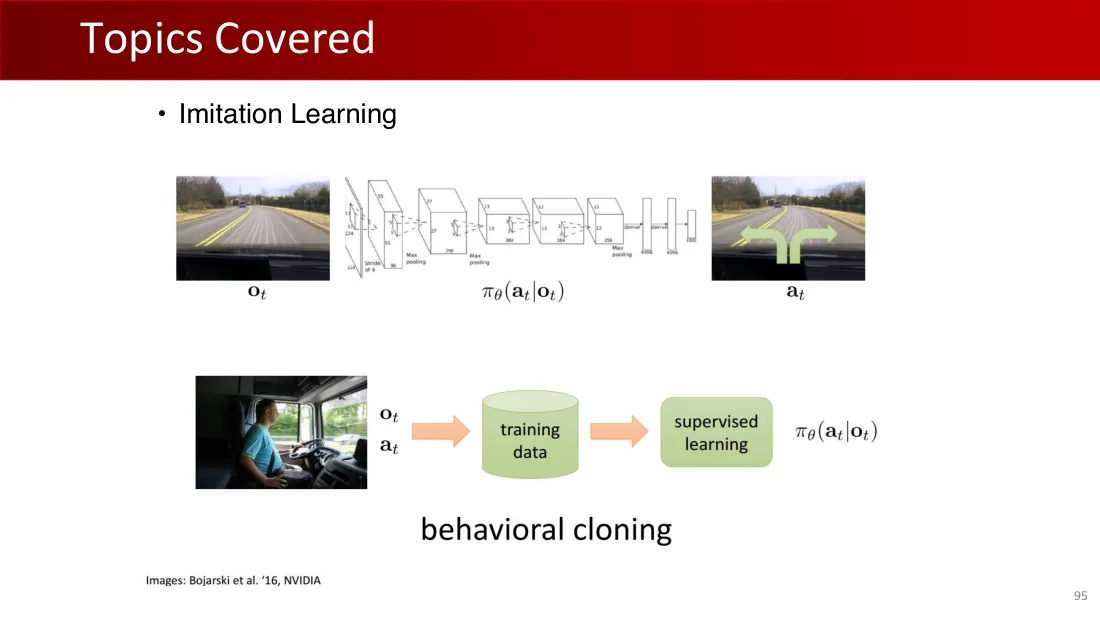
  • 模仿学习。

观察 \(o_t\) → 策略 \(\pi_\theta(a_t\mid o_t)\) → 动作 \(a_t\)。

步长4;最大池化;全连接。

\(o_t\)、\(a_t\) → 训练数据 → 监督学习 → \(\pi_\theta(a_t\mid o_t)\)。

行为克隆。

图片:Bojarski 等,2016,NVIDIA。

Lecture 01 · PDF p84

Lecture 1 英文原课件第84页
英文原页 · 点击在PDF中查看或放大
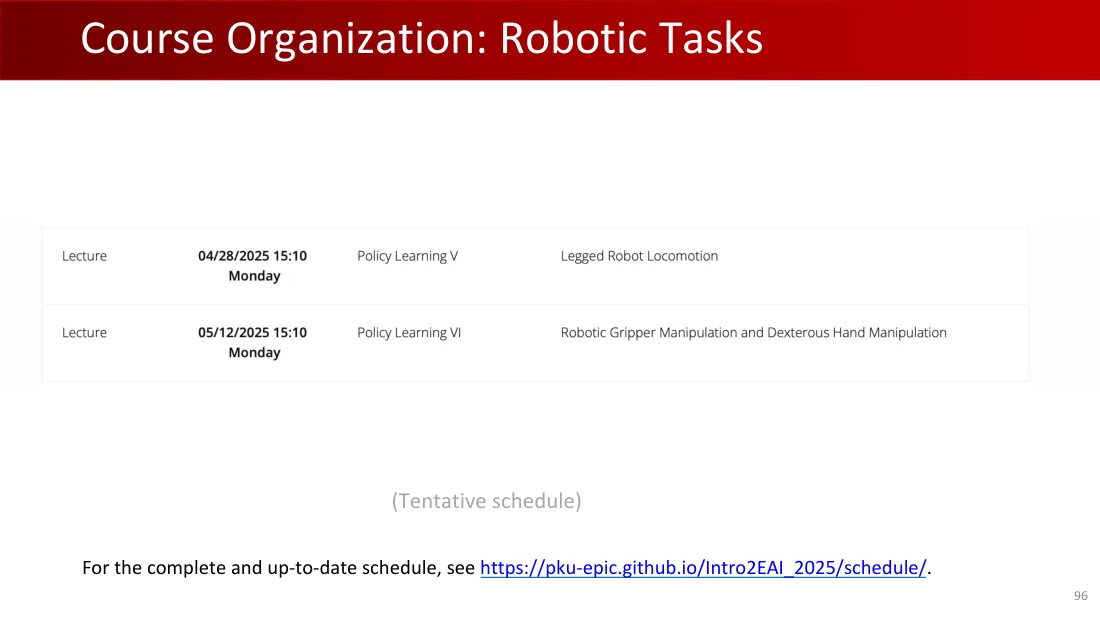
课程安排:机器人任务
活动日期与时间主题内容
授课2025年4月28日 星期一15:10策略学习 V足式机器人运动
授课2025年5月12日 星期一15:10策略学习 VI机器人夹爪操作与灵巧手操作

(暂定安排)

完整且最新的安排见 https://pku-epic.github.io/Intro2EAI_2025/schedule/。

Lecture 01 · PDF p85

Lecture 1 英文原课件第85页
英文原页 · 点击在PDF中查看或放大
涵盖的主题
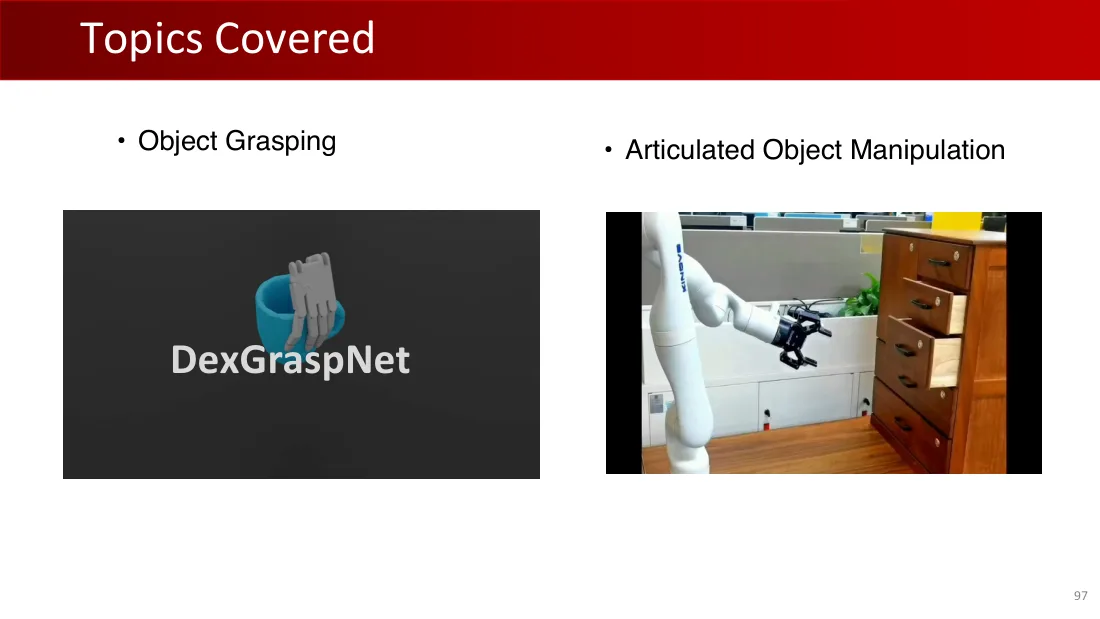
  • 物体抓取。
  • 关节物体操作。

DexGraspNet。

Lecture 01 · PDF p86

Lecture 1 英文原课件第86页
英文原页 · 点击在PDF中查看或放大
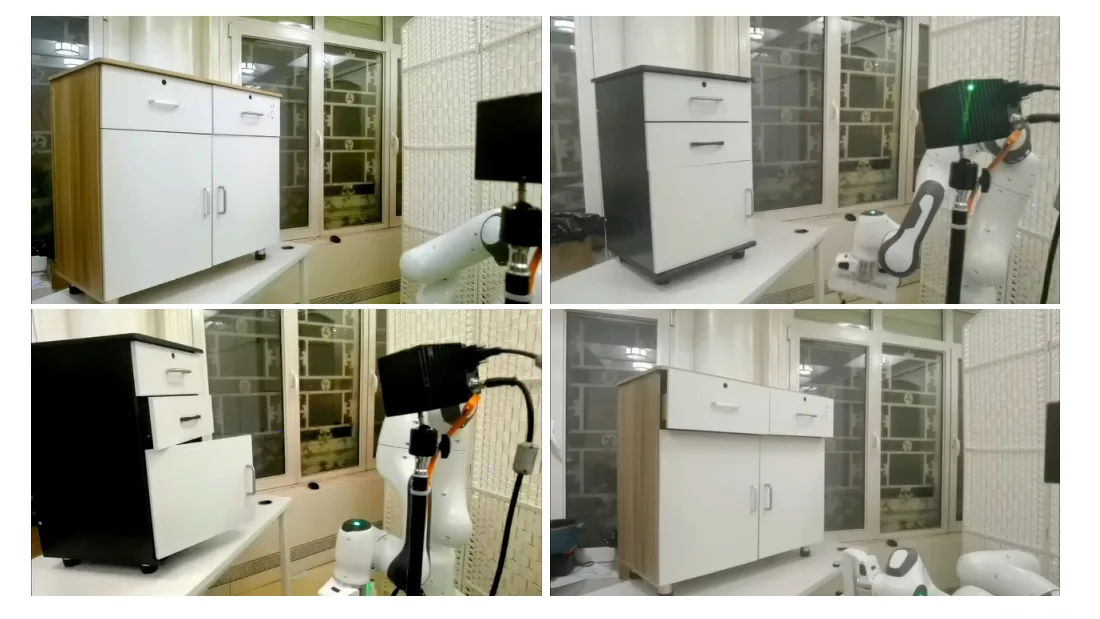
涵盖的主题
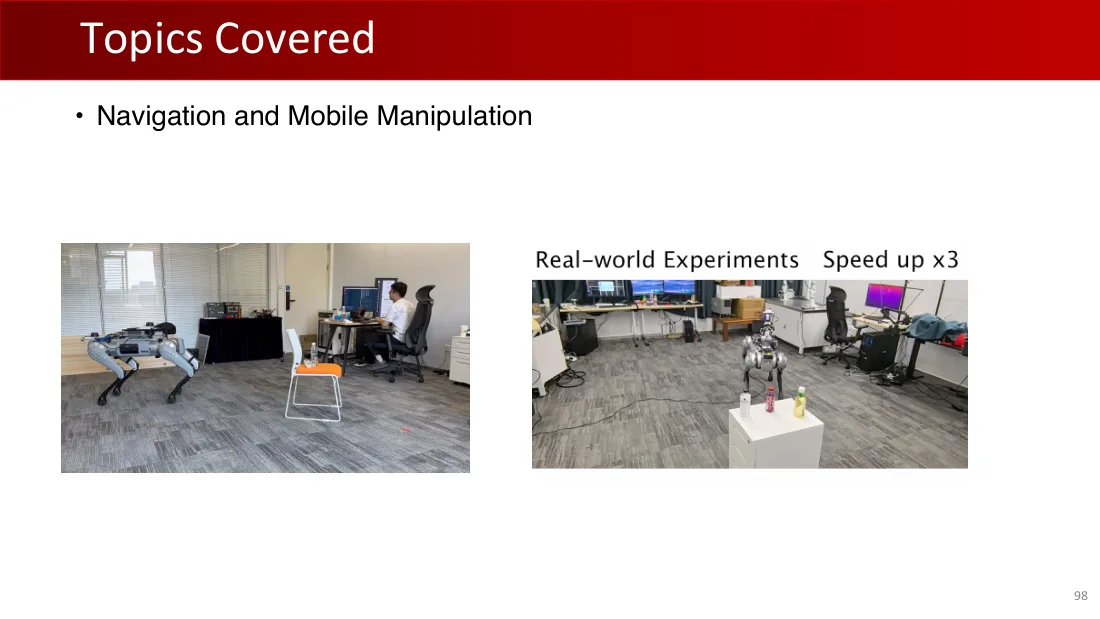
  • 导航与移动操作。

真实世界实验;3倍速。

Lecture 01 · PDF p87

Lecture 1 英文原课件第87页
英文原页 · 点击在PDF中查看或放大
涵盖的主题

QuadWBG。

Lecture 01 · PDF p88

Lecture 1 英文原课件第88页
英文原页 · 点击在PDF中查看或放大
涵盖的主题
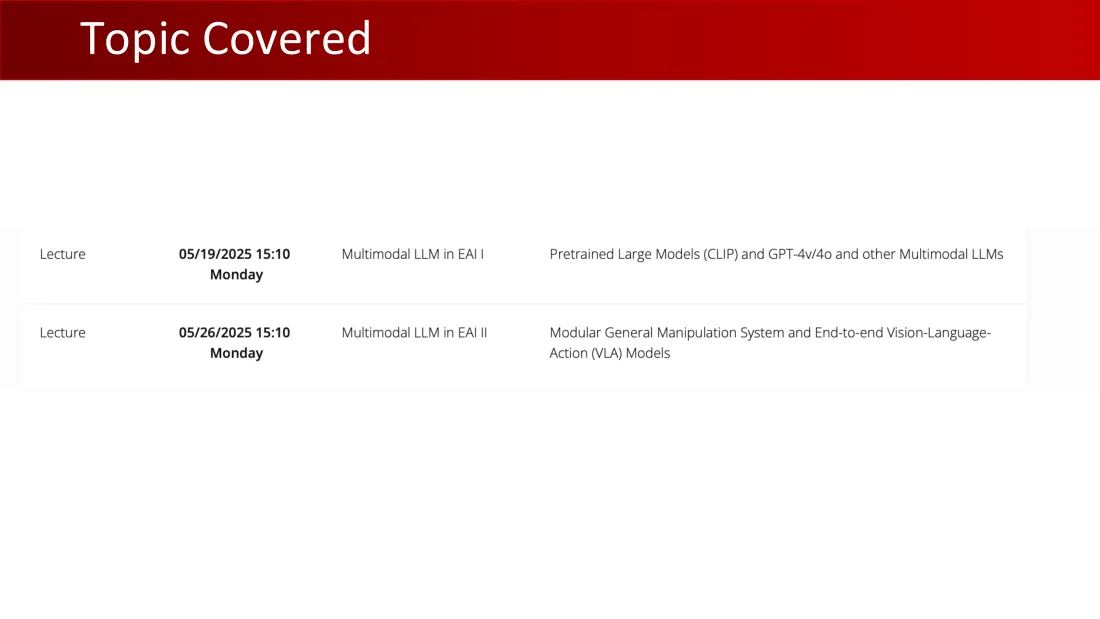
活动日期与时间主题内容
授课2025年5月19日 星期一15:10具身智能中的多模态大语言模型 I预训练大模型(CLIP)、GPT-4v/4o 及其他多模态大语言模型
授课2025年5月26日 星期一15:10具身智能中的多模态大语言模型 II模块化通用操作系统与端到端视觉—语言—动作(VLA)模型

Lecture 01 · PDF p89

Lecture 1 英文原课件第89页
英文原页 · 点击在PDF中查看或放大
具身智能导论

下周:第2讲,机器人学基础。

北京大学(1898年)

具身感知与交互实验室(EPIC)

2025年春季